# 哼哼猫文档 / MeowLoad Docs — 简体中文
> 哼哼猫的产品文档、命令行工具文档与开发者接口文档。产品侧覆盖 1000+ 站点的视频/图集/字幕下载、直播录制、格式转换与文案提取;开发者接口使用独立的 API 积分,提取成功才扣费。
---
# 哼哼猫文档中心: 哼哼猫电脑软件、浏览器插件的使用经验
> 分享哼哼猫电脑软件、浏览器插件和Web端的各种使用经验与技巧,涵盖视频下载、直播录制、格式转换、文案提取等功能教程,帮助用户高效获取、处理和转换各类网页多媒体资源。
来源: https://docs.henghengmao.com/docs
> 欢迎来到哼哼猫文档中心!在这里,我们分享哼哼猫电脑软件、浏览器插件以及 Web 端的各种使用经验和技巧,帮助你更高效地下载视频、录制直播、提取资源、批量剪辑视频等。
---
## 🚀 产品介绍
**哼哼猫**是一款功能强大的多媒体下载工具,支持视频下载、直播录制、文案提取、格式转换等多种功能。无论是保存喜欢的视频内容,还是录制精彩的直播时刻,哼哼猫都能轻松帮你实现。
### ✨ 核心特性
- 🎬 **视频/音频/图片下载** - 支持1000+网站的音视频图片资源下载
- 📡 **直播录制** - 实时录制 Twitch、TikTok、Kick 等平台直播流
- 🎵 **批量格式转换** - 支持视频、图片、音频上百种格式的互相转换
- 🔗 **浏览器插件** - 智能识别任何网页媒体资源
- ⚡ **批量处理** - 支持多任务同时下载/录制
---
## 📥 下载与安装
### 电脑软件版
- [**下载软件**](https://www.henghengmao.com/app)
- **支持系统**:Windows / macOS
### 浏览器插件版
- [**安装插件**](https://www.henghengmao.com/universal-media-downloader)
- **哼哼猫浏览器插件**:适用于 Chrome、Edge、夸克、QQ 等浏览器
- **功能**:网页视频嗅探、实时提取媒体资源
---
# 账号和会员常见问题
> 解答哼哼猫账号登录、同时登录设备数、密码错误排查、个人版和团队版会员区别等常见问题。帮助用户正确管理账号、升级会员版本、解决登录问题,快速上手使用。
来源: https://docs.henghengmao.com/docs/faq/account-and-membership-faq
关于哼哼猫账号和会员相关的常见疑问,本页面为您一一解答。包括账号登录限制、会员版本选择、密码错误处理等问题。
## 💡 个人版账号可以在几台电脑登录
个人版账号**最多可在 2 台电脑同时登录**。在网站上直接注册的账号为**个人版本账号**,因此受到同时登录设备数的限制。此限制主要是为了保护账号安全和公平使用。
如果您的使用场景超过 2 台设备(比如团队/企业场景),可以联系客服付费**升级为团队版本账号**。
> [!WARNING]
>
> **注意事项**
>
> 如果检测到异常的同时登录行为(如频繁在多地登录),系统会出于安全考虑对账号进行限制。请妥善保管账号信息。
## 👥 有团队/企业版本会员吗?
哼哼猫对团队和企业用户提供了**专门的团队版本会员**。请联系客服购买团队版本会员。
## 🔑 登录时提示账号或密码错误?
**常见原因和解决方案:**
| 问题 | 现象 | 解决方案 |
|------|------|---------|
| **大小写错误** | 密码中有大写字母,但输入时全部小写 | 检查 Caps Lock 是否开启,仔细输入密码 |
| **邮箱后缀错误** | 常见的 `.com` 打成了 `.con` 或其他 | 仔细检查邮箱后缀,特别注意 `.com`、`.cn` 等 |
| **中英文标点混用** | 密码中用的是英文标点,但输入了中文标点 | 关闭中文输入法,切换到英文输入法后重新输入 |
| **全角和半角混用** | 密码中是半角符号,输入时变成了全角 | 确保使用英文输入法(半角状态)输入特殊符号 |
> [!TIP]
>
> **小贴士**
>
> 如果密码中包含特殊符号,建议在输入前验证输入法状态:
> - **英文输入法**(推荐):显示标点为半角
> - **中文输入法全角状态**:标点会加宽,容易出错
**还是无法登录?**
如果按照上述方案检查后仍无法登录,可以点击「**忘记密码**」进行重置 或 联系客服寻求帮助
---
# 批量下载的文件如何保持顺序?
> 详细讲解哼哼猫批量下载文件时如何保持文件顺序的两种实用方法:利用文件修改时间自动排序和在文件名前添加序号。解决批量下载视频、图片等资源后文件顺序混乱的问题,让文件管理更轻松高效。
来源: https://docs.henghengmao.com/docs/faq/how-to-keep-downloaded-files-in-order
批量下载文件时,保持文件顺序对于后续整理和查看非常重要。哼哼猫提供了两种方式来保持文件下载顺序。
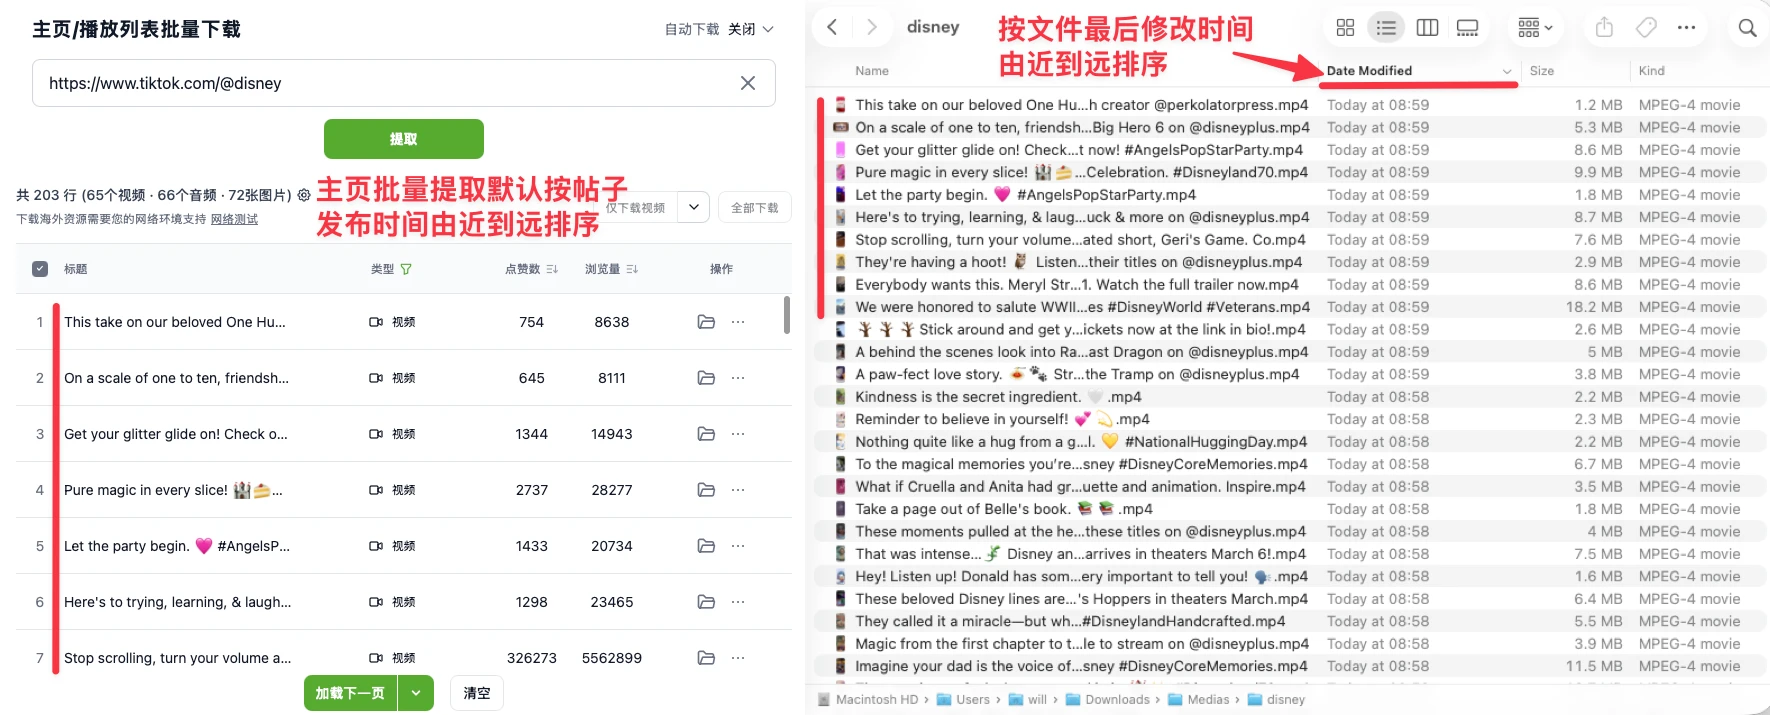
## 方式1:默认支持按文件最后修改时间排序
不需要做任何设置,批量下载的文件会自动按文件在提取结果表格里的展示顺序设置修改时间。在文件夹中按「最后修改时间」由近到远排序,文件顺序就和提取结果表格中的顺序一致(默认按帖子发布时间由近到远)。
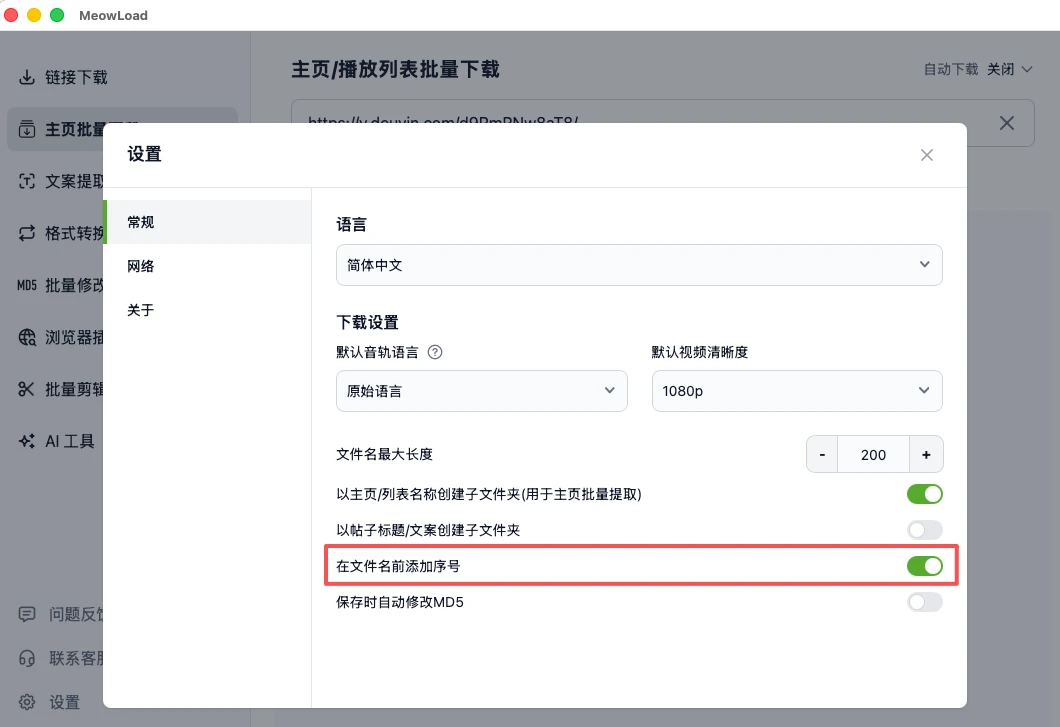
## 方式2:在文件名前添加序号
如果在软件设置中勾选了「在文件名前添加序号」,下载的文件名前面会自动添加序号(序号对应资源在提取结果表格中的位置)。文件下载完成后,可以直接按文件名排序。
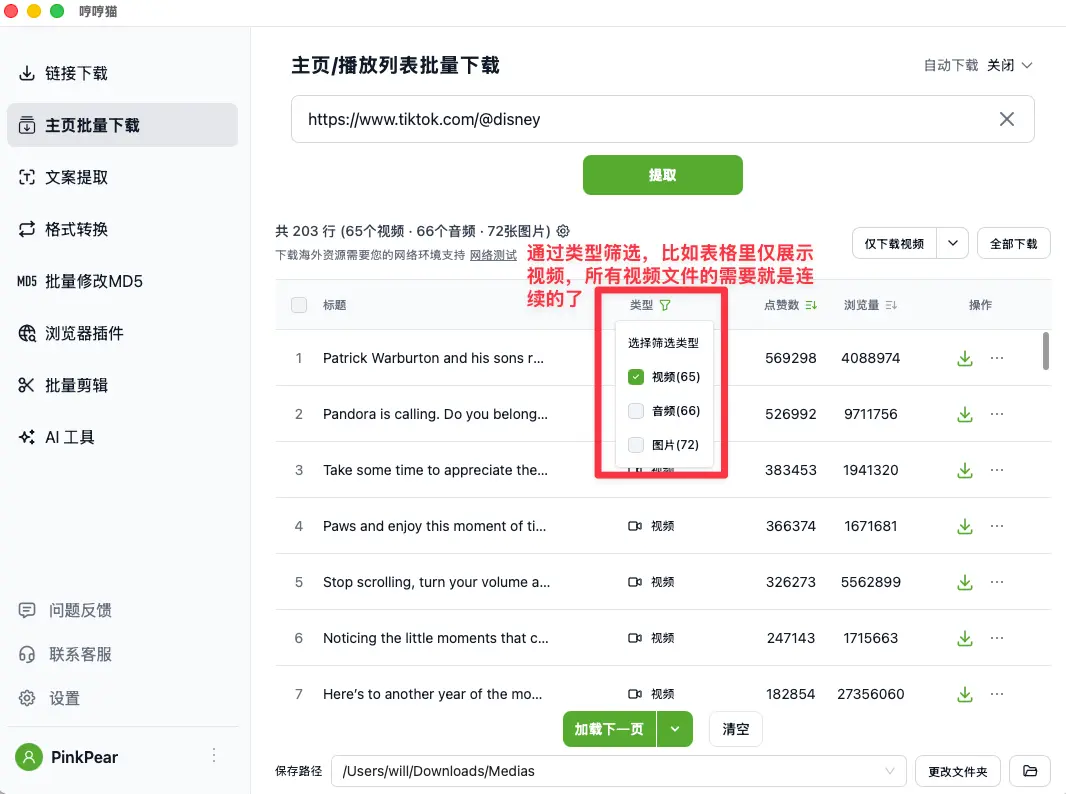
 ### 💡 常见问题:为什么「仅下载视频」时序号不连续?
**原因:** 文件名前的序号对应的是资源在提取结果表格中的位置。点击「仅下载视频」时,表格中仍然包含其他类型的资源(音频、图片、字幕等),所以视频的序号会出现跳号。
**解决方法:**
如果想让下载的视频序号连续,可以按以下步骤操作:
1. 在提取结果表格中,使用「类型筛选」功能
2. 选择仅展示视频
3. 筛选后,视频在表格中的序号会变成连续的
4. 点击「全部下载」,下载的视频文件序号就是连续的了
 ---
# 批量下载视频 - 多平台视频图片一键批量保存
> 哼哼猫支持批量下载功能,一次粘贴多个推特、YouTube、Instagram等平台的分享链接,自动识别所有视频、图片、音频、直播、字幕资源,支持筛选和一键批量下载到本地。
来源: https://docs.henghengmao.com/docs/video-downloads/bulk-video-downloader
## 功能简介
**多链接批量下载**功能支持一次性粘贴几十个不同网站的分享链接,哼哼猫会自动解析所有链接并获取其中包含的媒体资源,包括:
- 🎬 视频文件
- 🖼️ 图片文件
- 🎵 音频文件
- 📡 直播流
- 📝 字幕文件
## 使用步骤
### 1. 粘贴多个链接
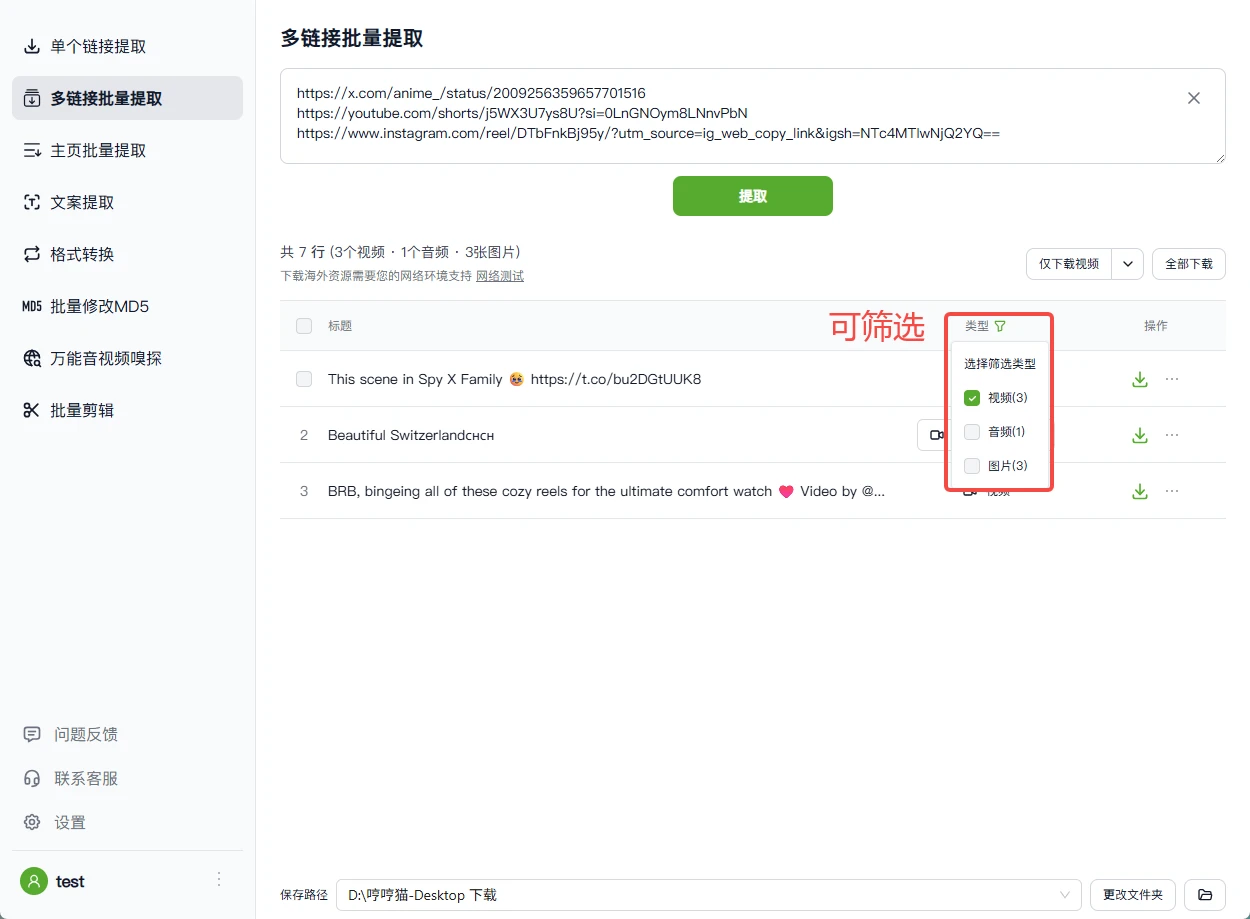
例如,你在推特、YouTube、Instagram 上分别看到了喜欢的视频,只需将这些页面的分享链接一次性粘贴到哼哼猫中。软件会自动识别和解析所有链接。
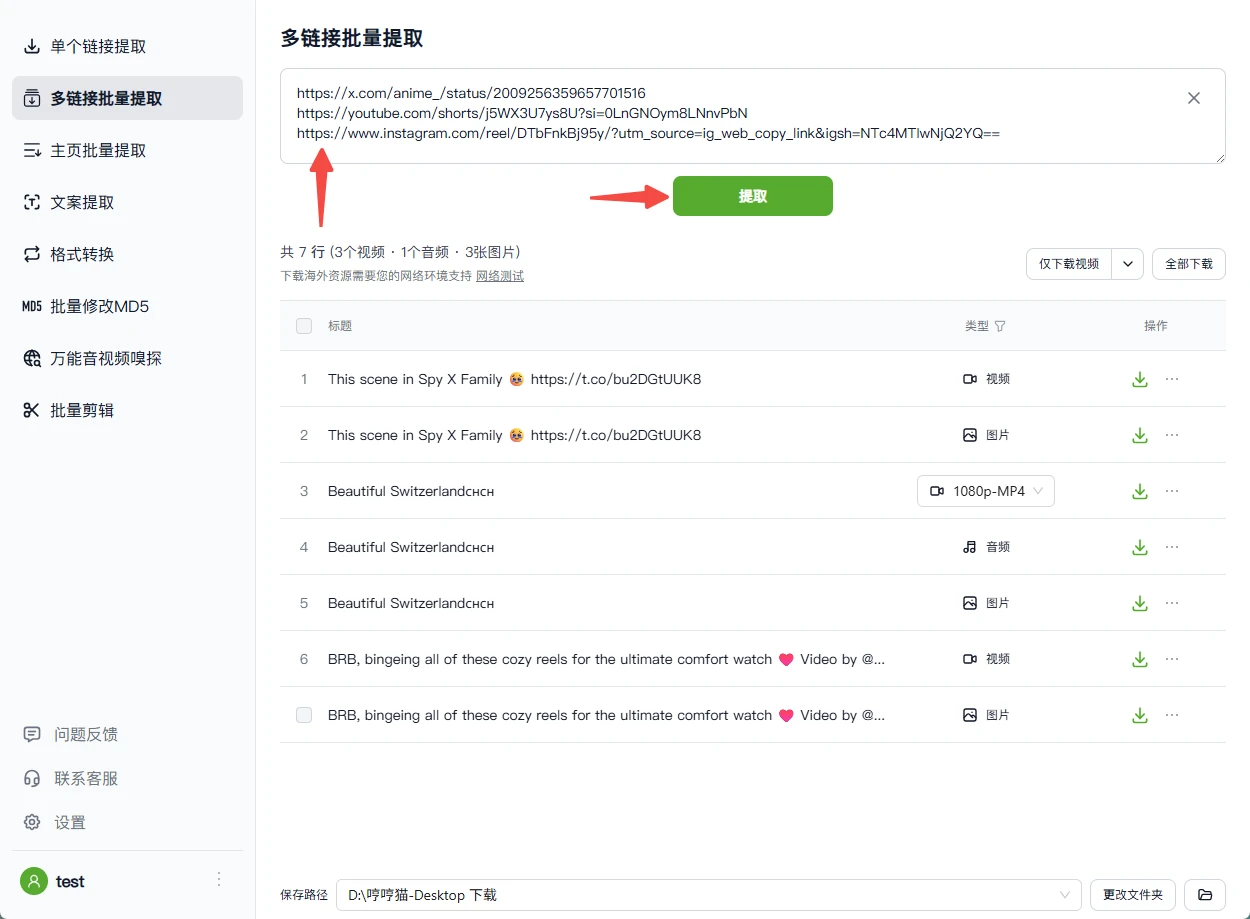 ### 2. 筛选和下载
软件解析完成后,你可以:
- **按类型筛选**:只显示视频、图片或其他特定类型的文件
- **多选下载**:手动勾选需要的文件
- **一键全部下载**:点击下载按钮,将所有资源批量保存到本地
 ## 功能特点
- ✅ **跨平台支持**:支持 YouTube、推特、Instagram、TikTok 等1000+视频平台
- ✅ **智能识别**:自动识别帖子中的所有媒体资源
- ✅ **灵活筛选**:支持按文件类型筛选,精准下载
- ✅ **批量处理**:一次处理几十个链接,大大提高效率
---
# 如何下载 iFunny 视频?
> 详细教程教你如何使用哼哼猫软件下载 iFunny 搞笑视频、meme 图片和 GIF 动图。只需复制视频链接并粘贴到软件,自动解析并保存到本地,操作简单快速,无水印高清下载。
来源: https://docs.henghengmao.com/docs/video-downloads/how-to-download-ifunny-videos
**iFunny** 是一个国外热门的搞笑内容社区,汇集了大量有趣的 meme 图片、GIF 和短视频。如果你在 iFunny 上看到喜欢的视频想保存到本地,只需两步即可轻松下载。
## 第一步:复制视频链接
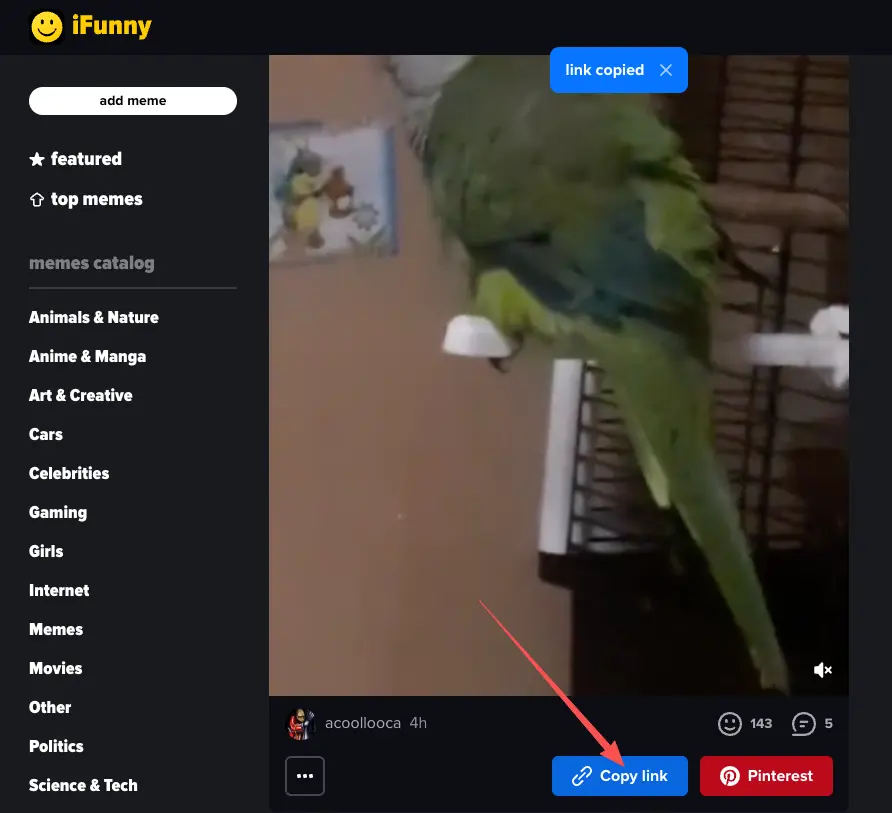
打开 iFunny 网站,找到你想下载的视频。在视频播放区域的下方,点击 **Copy link** 按钮,页面顶部会提示「link copied」,说明链接已成功复制到剪贴板。
 ## 第二步:粘贴链接并下载
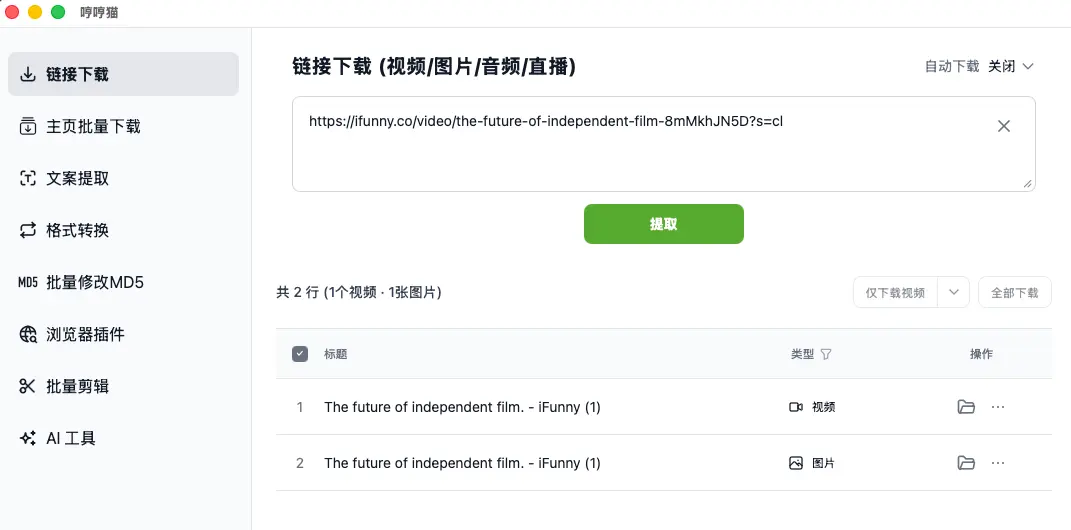
打开**哼哼猫**,选择左侧菜单的「**链接下载**」功能。将刚才复制的链接粘贴到输入框中,点击绿色的「**提取**」按钮。
软件会自动解析链接内容,并在下方列表中显示可下载的媒体文件(包括视频和封面图片)。你可以选择「仅下载视频」或「全部下载」,文件会自动保存到本地。
 ---
# Sora2 AI 视频去水印保存到本地
> 详细介绍如何使用哼哼猫在线工具或桌面客户端去除 Sora2 AI 生成视频的水印并保存到本地。支持单个链接提取下载和多链接批量去水印下载,操作简单,轻松获取无水印高清视频。
来源: https://docs.henghengmao.com/docs/video-downloads/sora2-watermark-remover
> [!WARNING]
>
> **本功能已停用。** OpenAI 已停止提供 Sora 2,Sora 分享链接无法再解析,本页仅作存档。其他平台的批量下载请看 [批量下载视频](https://docs.henghengmao.com/docs/video-downloads/bulk-video-downloader)。
Sora2 是一款热门的 AI 视频生成工具,但分享出来的视频通常带有平台水印。本文介绍如何使用哼哼猫去除 Sora2 视频水印,将无水印视频保存到本地。
## 复制分享链接
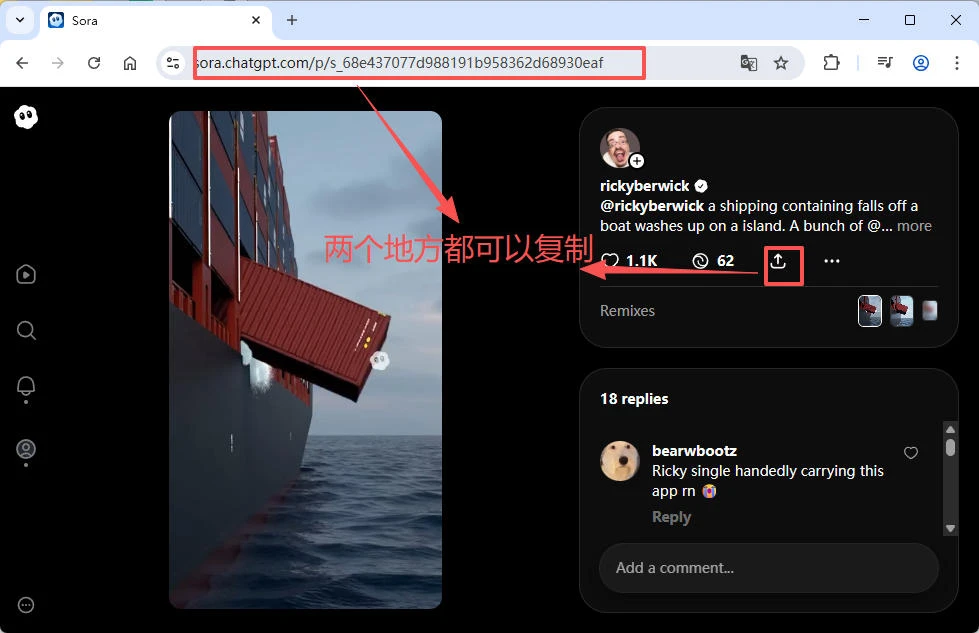
在 Sora2 的 APP 或网站上,找到要下载的视频,点击分享并复制视频链接。
## 单个链接去水印下载
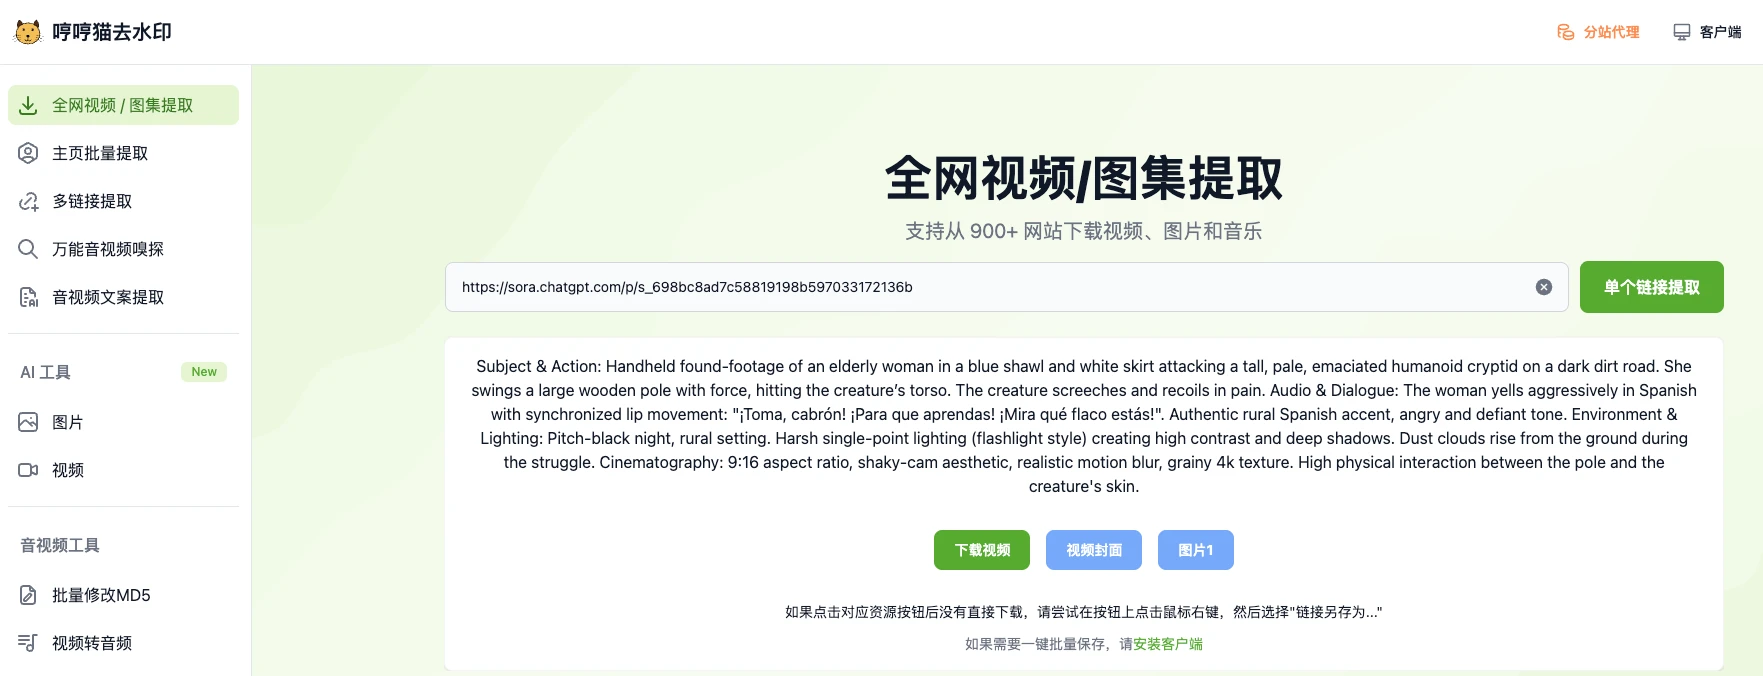
访问 **[哼哼猫去水印网站](https://www.henghengmao.com/)**,粘贴刚才复制的 Sora2 视频分享链接,点击 **提取** 按钮即可获取无水印视频,然后点击 **下载** 保存到本地。
## 批量去水印下载
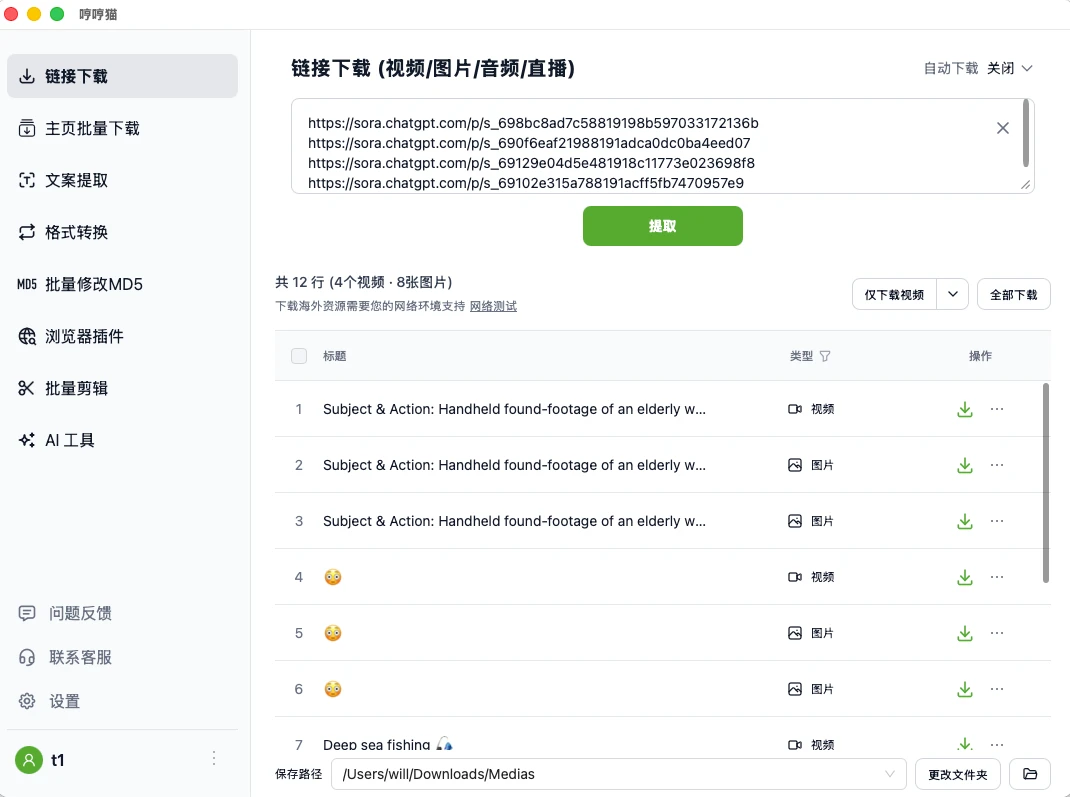
如果需要批量下载,可以使用 **[哼哼猫桌面客户端](https://www.henghengmao.com/app)**,一次可粘贴几十个链接,一键批量下载无水印的视频和图片。
---
# 如何批量下载主页、播放列表、频道和 Hashtag 页面的视频、音频和图片?
> 使用哼哼猫电脑版的主页批量下载功能,粘贴创作者主页、播放列表、频道或话题标签链接,即可一键批量提取并下载视频、音频和图片,支持 YouTube、Instagram、TikTok、SoundCloud、抖音、B 站等平台。
来源: https://docs.henghengmao.com/docs/video-downloads/batch-download-profile-playlist
遇到喜欢的创作者,想把 TA 主页的作品都下载下来慢慢看,却要一个个手动保存?
[哼哼猫](https://www.henghengmao.com/app) 电脑版提供了**主页/播放列表批量下载**功能,只需粘贴创作者的主页链接,就能自动提取页面内可获取的视频、音频和图片,一键批量下载到本地。该功能已支持 1000+ 网站,包括但不限于:
- **YouTube**:频道页、播放列表、Shorts 页面
- **Instagram**:用户主页、Hashtag 页面
- **TikTok**:用户主页、Hashtag 页面
- **B站**:用户主页、合集页面
- **SoundCloud**:作者主页、播放列表、专辑中的公开音频
- 以及 Twitter(X)、Twitch、微博、AcFun 等更多平台
## 操作步骤
### 第一步:复制目标页面链接
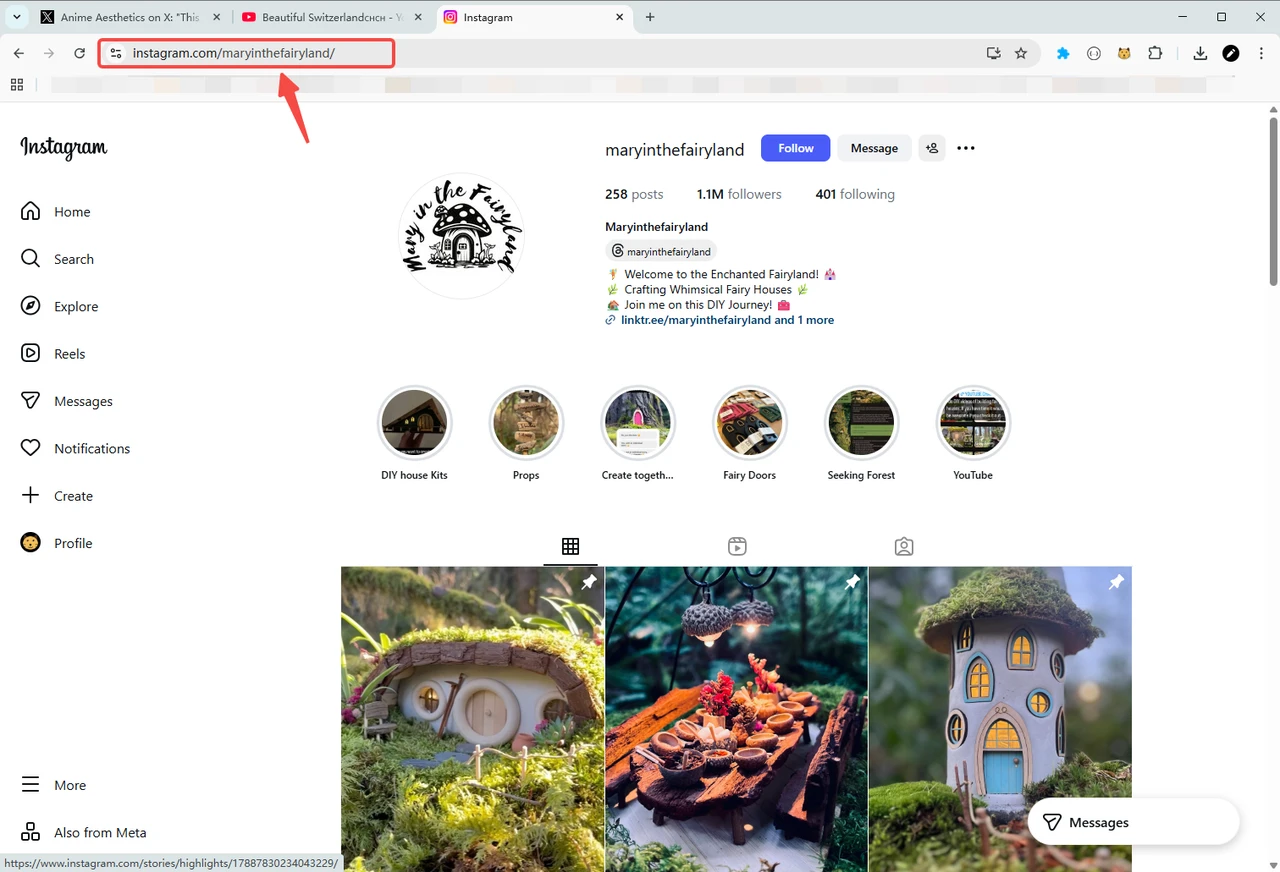
打开你想批量下载的创作者主页、播放列表、频道页或话题标签页,从浏览器地址栏复制页面链接。
### 第二步:粘贴链接并提取
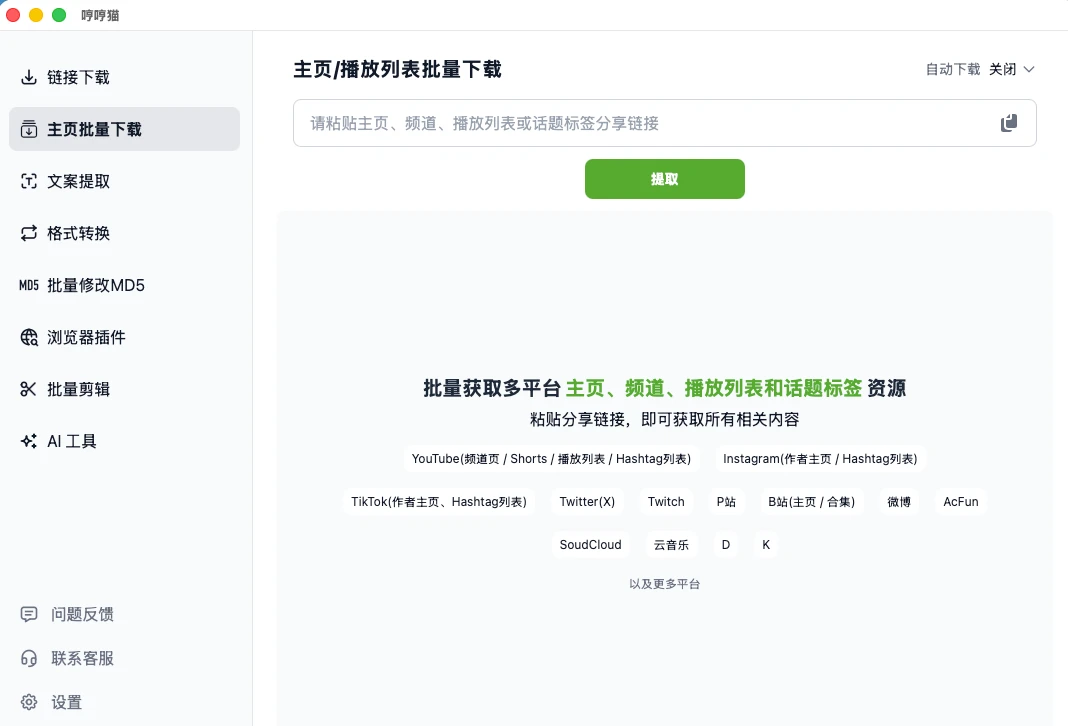
打开哼哼猫电脑软件,在左侧菜单选择**主页批量下载**,将复制的链接粘贴到输入框中,点击**提取**按钮。
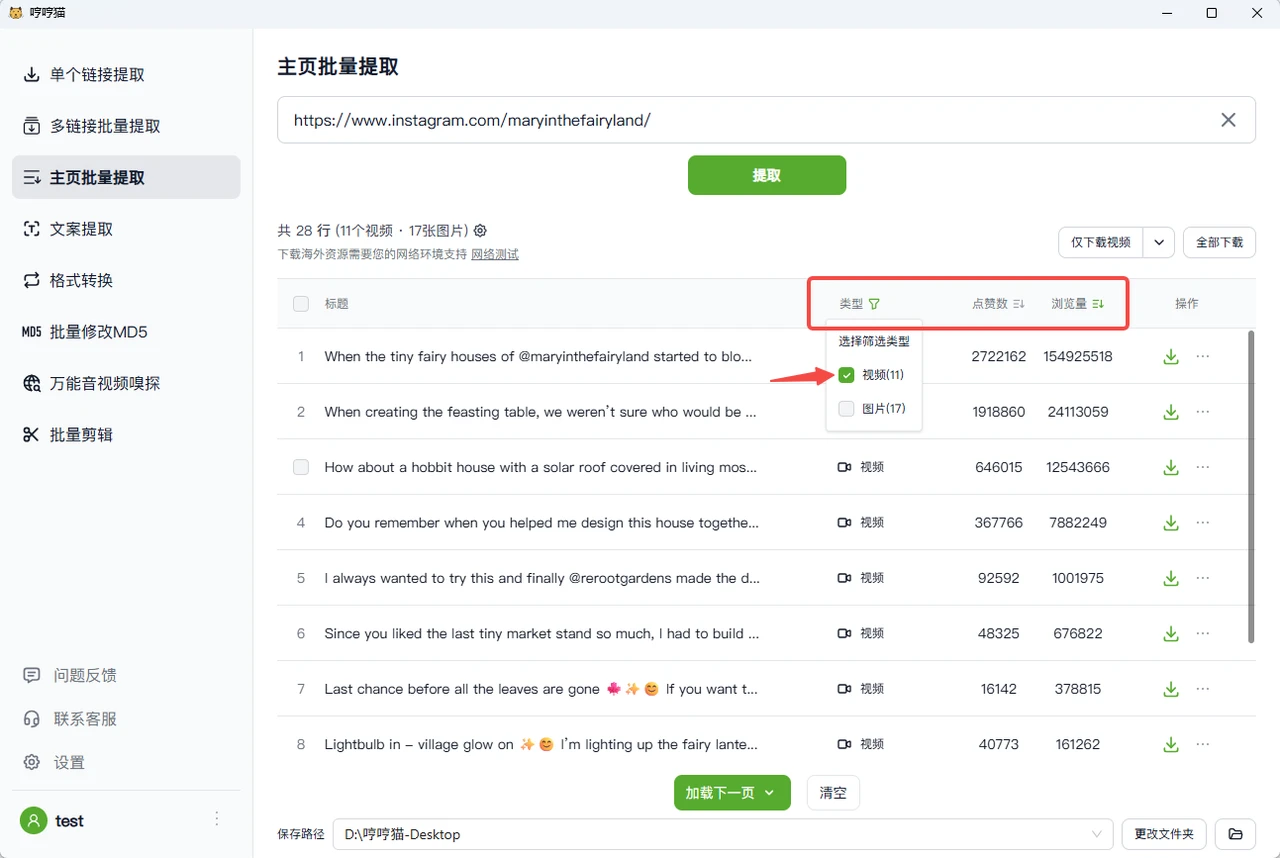
软件会按作品发布时间从近到远分页提取内容。你可以点击**加载下一页**逐页加载,也可以选择**一次加载 5 页**或**一次加载全部**来获取列表中的所有作品。
### 第三步:排序、筛选并批量下载
提取完成后,你可以对结果进行调整:
- **排序**:默认按发布时间由近到远排列,也支持按浏览量或点赞数排序
- **筛选**:按文件类型筛选,包括视频、音频、图片和字幕
确认后点击**全部下载**即可一键批量保存到本地。也可以通过**仅下载视频**等快捷按钮,只下载某一类型的文件。
---
# 如何录制 Twitch 的直播?
> 详细教程教你如何使用哼哼猫软件录制 Twitch 游戏直播,只需复制直播间链接并粘贴到软件,即可实时录制主播精彩内容并保存到本地。支持自动解析视频流、音频和封面,操作简单高效。
来源: https://docs.henghengmao.com/docs/livestream-recording/how-to-record-twitch-live-streams
**Twitch** 是全球最大的游戏直播平台,汇聚了海量主播的精彩直播内容。如果你想录制喜欢的直播节目以便后续回看,使用**哼哼猫**软件可以轻松实现实时录制。只需两步操作,即可将正在进行的直播保存到本地。
## 第一步:复制直播间链接
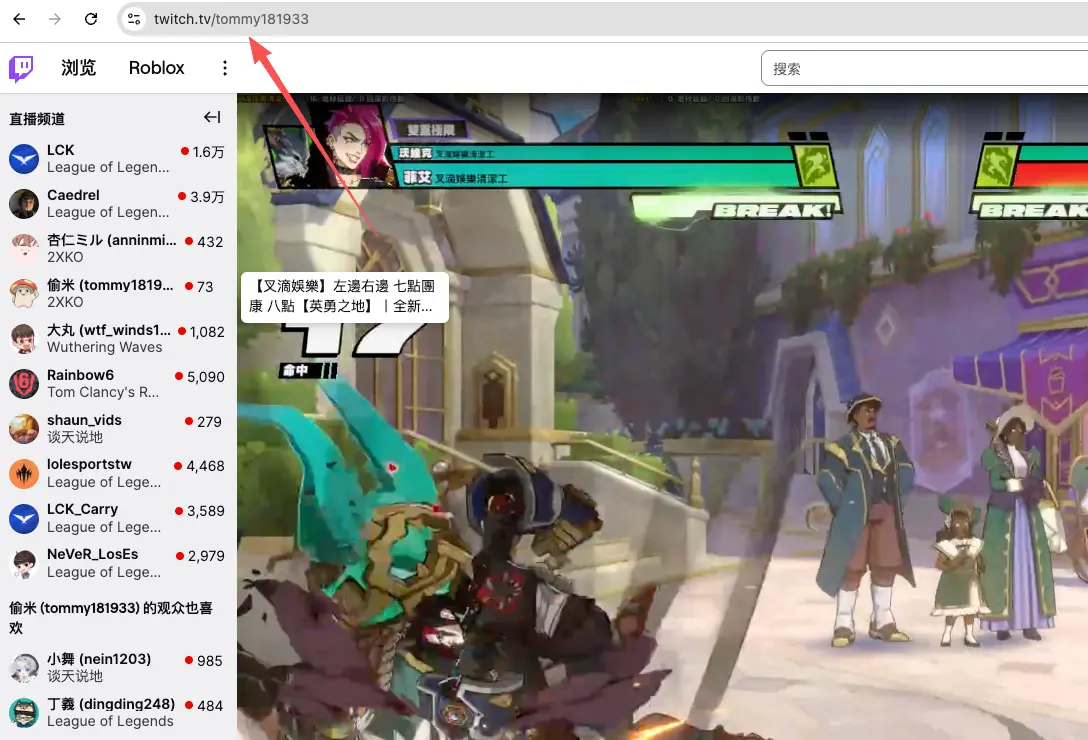
打开 Twitch 网站,进入你想录制的直播间。在浏览器地址栏中复制完整的直播间链接(格式通常为 `https://www.twitch.tv/主播用户名`)。
 ## 第二步:粘贴链接并开始录制
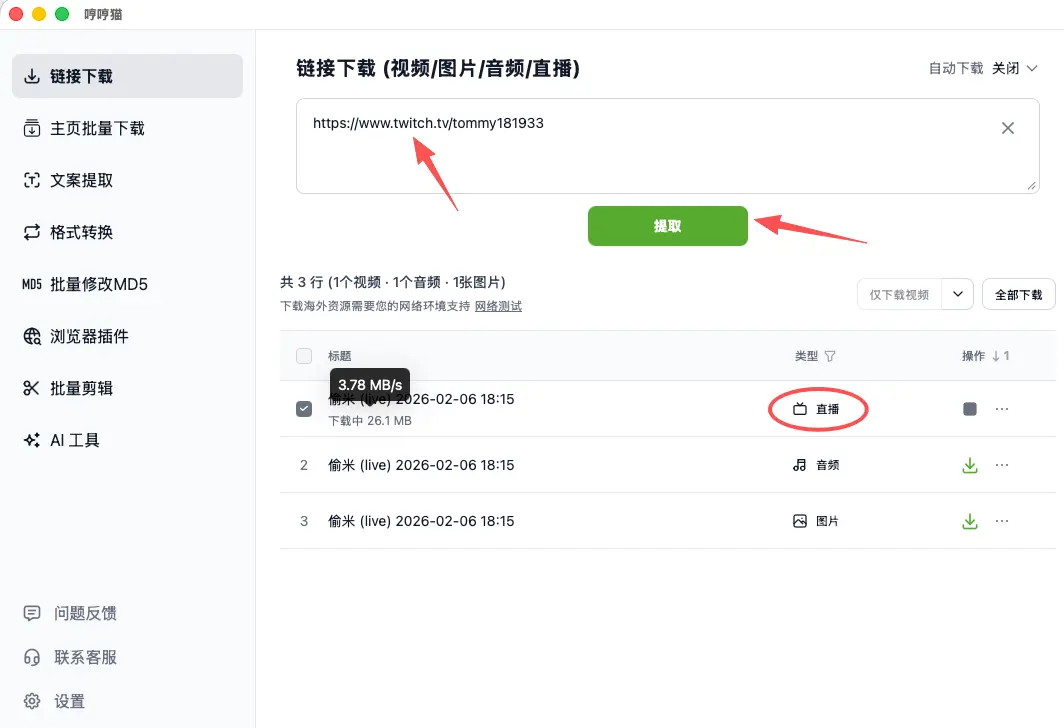
打开**哼哼猫**软件,选择左侧菜单的「**链接下载**」功能。将刚才复制的 Twitch 链接粘贴到输入框中,点击绿色的「**提取**」按钮。
软件会自动解析直播内容,并在下方列表中显示可下载的媒体文件(包括视频流、音频和封面图)。第一行会显示「**直播**」状态标签,表示正在实时录制。你可以看到实时下载速度和已录制的文件大小。
 **提示**:直播录制会持续进行,直到主播结束直播或你手动停止。录制的视频文件会自动保存到软件设置的下载目录中。
---
# 如何录制 Kick 直播?
> 详细教程:使用哼哼猫电脑软件录制Kick平台的直播内容,以及下载Kick平台已发布的视频。通过链接下载功能,只需复制直播间或视频链接,即可轻松实现实时录制和视频下载,支持最高画质保存。
来源: https://docs.henghengmao.com/docs/livestream-recording/how-to-record-kick-live-streams
> 本文介绍如何使用哼哼猫电脑软件录制 Kick 平台的直播内容,以及下载 Kick 平台已有的视频。
## 功能说明
哼哼猫电脑软件支持两种 Kick 内容获取方式:
1. **直播录制** - 实时录制 Kick 平台的直播流
2. **视频下载** - 下载 Kick 平台的已发布视频内容
两种功能都通过「**链接下载**」功能实现,操作流程完全相同。
---
## 第一步:复制 Kick 链接
### 录制直播
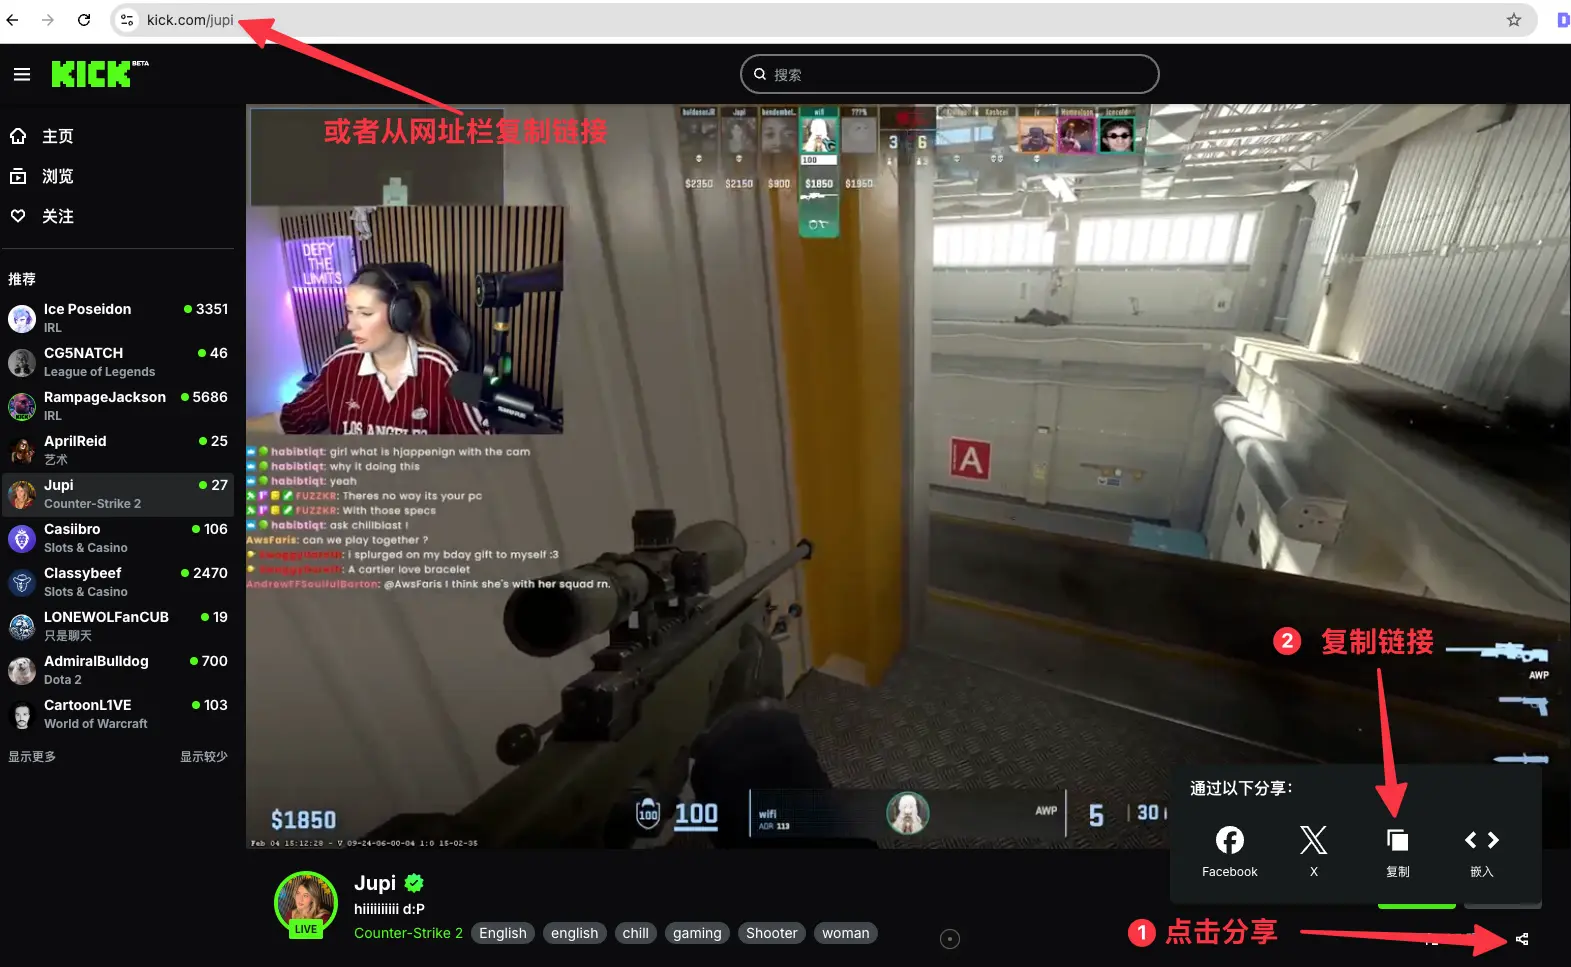
进入想要录制的 Kick 直播间,**复制浏览器地址栏中的链接**:
`https://kick.com/[主播用户名]`
例如:`https://kick.com/jupi`
 **提示**:
- 点击 "复制链接" 按钮快速复制直播间链接
- 或从网址栏直接复制整个链接
### 下载已发布视频
进入 Kick 平台的视频链接,**复制视频页面的链接**:
`https://kick.com/[主播用户名]/videos/[视频ID]`
例如:`https://kick.com/jeff-jian-57/videos/4ef3e6bc-d963-4a04-8b3a-dd0cc0c66f89`
操作方式与直播录制相同。
---
## 第二步:粘贴链接并开始
打开哼哼猫软件,进入「**链接下载**」功能:
1. **粘贴链接** - 将复制的 Kick 链接粘贴到文本框中
2. **提取直播间信息** - 点击「**提取**」按钮,软件会自动解析该链接
3. **开始录制/下载** - 点击「**开始录制**」按钮,开始实时录制或下载视频
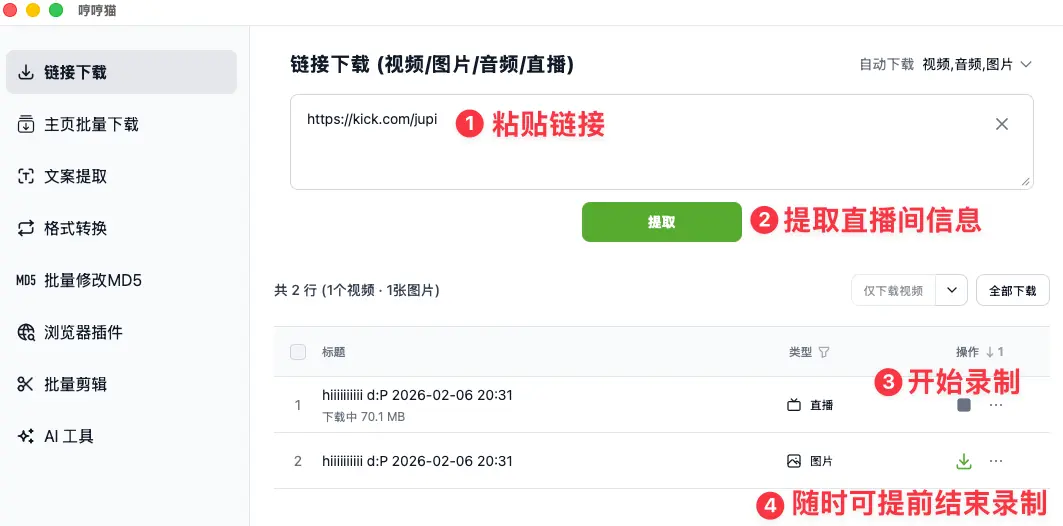 **软件会自动显示**:
- 直播流信息(用于录制)或视频信息(用于下载)
- 提取结果包括视频流、音频流和封面图
- 下载进度实时显示
---
## 使用提示
| 项目 | 说明 |
|------|------|
| **直播录制** | 实时录制正在进行的直播,可随时点击停止 |
| **视频下载** | 下载已发布的视频,通常速度更快 |
| **保存位置** | 所有文件默认保存到软件设置的下载文件夹 |
| **文件格式** | 自动下载最高质量的视频和音频 |
| **网络要求** | 需要稳定的网络连接,建议使用有线网络 |
---
## 常见问题
**Q: 可以同时录制多个直播吗?**
A: 哼哼猫支持批量处理,可以添加多个链接到队列中顺序处理。
**Q: 直播录制时间有限制吗?**
A: 没有时间限制,可以一直录制直到直播结束或手动停止。
**Q: 下载的文件在哪里?**
A: 所有下载文件保存在哼哼猫的下载文件夹中,可在软件设置中查看或修改保存位置。
---
# 安装哼哼猫浏览器插件
> 详细介绍哼哼猫浏览器插件的安装方法,支持 Chrome、Edge、夸克等主流浏览器。提供应用商店一键安装和手动安装两种方式,安装后可自动嗅探网页中的视频、音频和直播资源并下载。
来源: https://docs.henghengmao.com/docs/browser-extension/install-meowload-extension
哼哼猫浏览器插件支持 Chrome、Edge、夸克、QQ 浏览器、360 浏览器、Opera、Yandex 等主流浏览器,推荐在 Chrome 或 Edge 中使用。以下介绍两种安装方式。
## 从应用商店安装(推荐)
这是最简单也是最推荐的安装方式,直接从官方商店安装:
- **Chrome 浏览器**:访问 [Chrome 应用商店](https://chromewebstore.google.com/detail/meowload-videoliveaudioim/gnplpcfnikehohdgnfnfcienljcbaogj)
- **Edge / 夸克浏览器**:访问 [Edge 应用商店](https://microsoftedge.microsoft.com/addons/detail/mfmeocjfdcmipdcebfdgpncpmcddmech)
**第一步**:在应用商店页面点击 **添加扩展程序** 按钮。
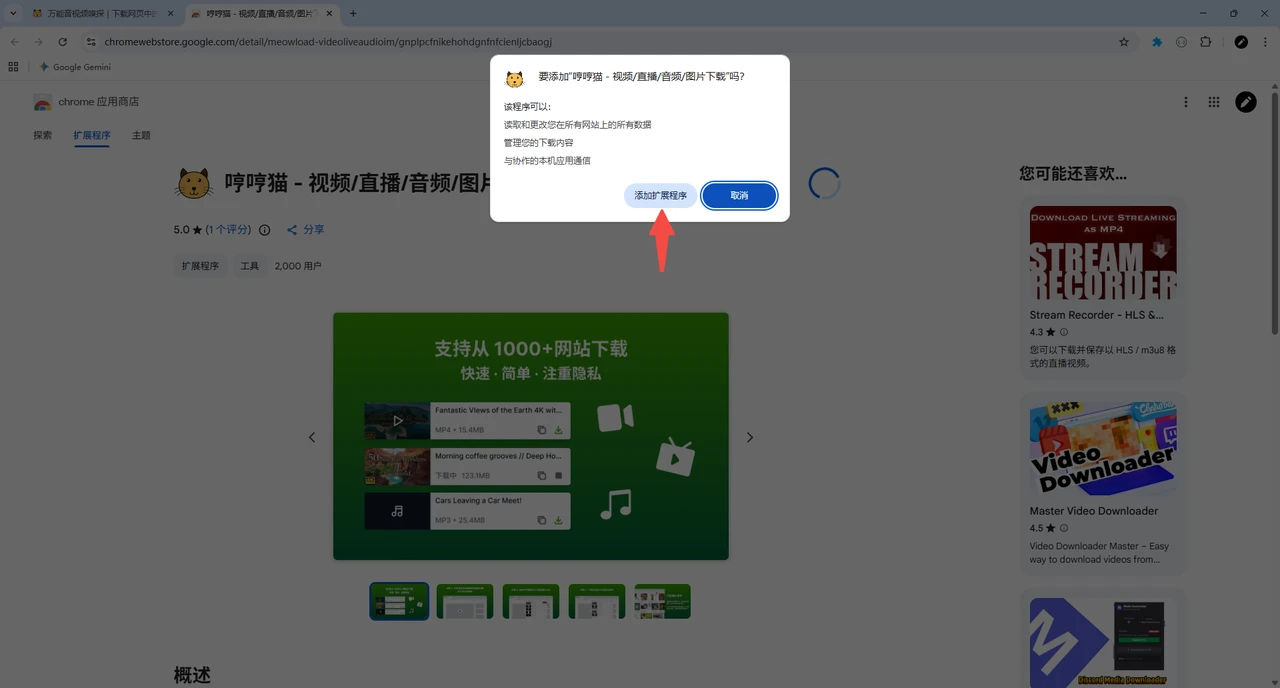
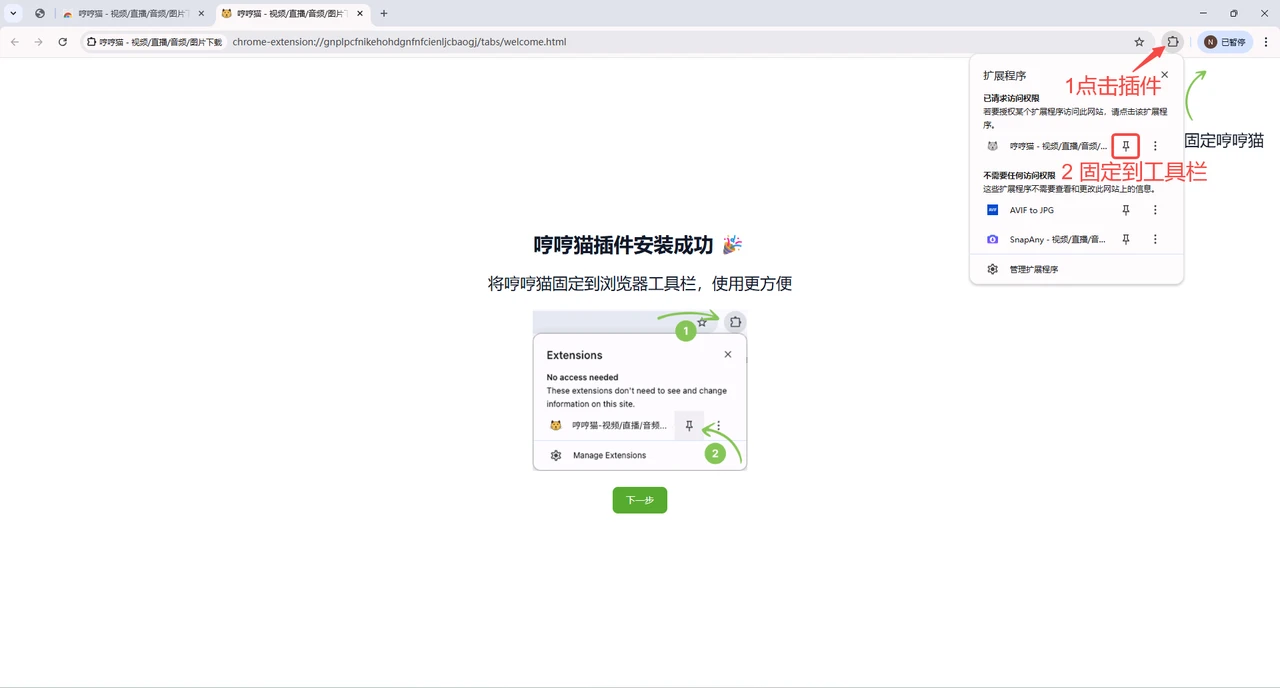
**第二步**:安装完成后,点击浏览器右上角的插件图标,将哼哼猫 **固定至工具栏**。
当你访问任何网页时,如果页面中包含可播放的视频、音频或直播,哼哼猫图标会自动点亮。点击图标即可查看嗅探到的资源,选择需要的内容下载保存到本地。
## 手动安装
如果你使用的浏览器无法访问应用商店,可以通过 **[手动安装方式](https://www.henghengmao.com/manual-install-extension)** 完成安装。
---
# 如何下载电商平台的产品视频
> 使用哼哼猫浏览器插件一键下载京东、淘宝、拼多多、亚马逊等电商平台的商品主图视频。无需录屏,直接获取高清原视频。该方法同样适用于任何网页中的视频、音频和直播资源。
来源: https://docs.henghengmao.com/docs/browser-extension/download-ecommerce-product-videos
在京东、淘宝、拼多多、亚马逊等电商平台上看到不错的商品视频,想保存下来做素材,却发现右键没有「另存为」的选项?用手机录屏画质模糊、杂音多,效果很差。
使用哼哼猫浏览器插件,可以直接获取高清原视频,告别模糊录屏。
> 这是一个**通用方法**,不仅适用于电商产品视频,**任何网页中包含的视频、音频、直播**都可以用同样的方式下载。
## 安装哼哼猫浏览器插件
在浏览器应用商店安装哼哼猫插件:
- **Chrome 浏览器**:[Chrome 应用商店安装](https://chromewebstore.google.com/detail/meowload-videoliveaudioim/gnplpcfnikehohdgnfnfcienljcbaogj)
- **Edge / 夸克浏览器**:[Edge 应用商店安装](https://microsoftedge.microsoft.com/addons/detail/meowload-videoliveaud/mfmeocjfdcmipdcebfdgpncpmcddmech)
> 详细安装步骤请参考 [安装哼哼猫浏览器插件](https://docs.henghengmao.com/docs/browser-extension/install-meowload-extension)。
## 下载产品视频
下面以京东为例演示,其他电商平台操作方法完全一样。
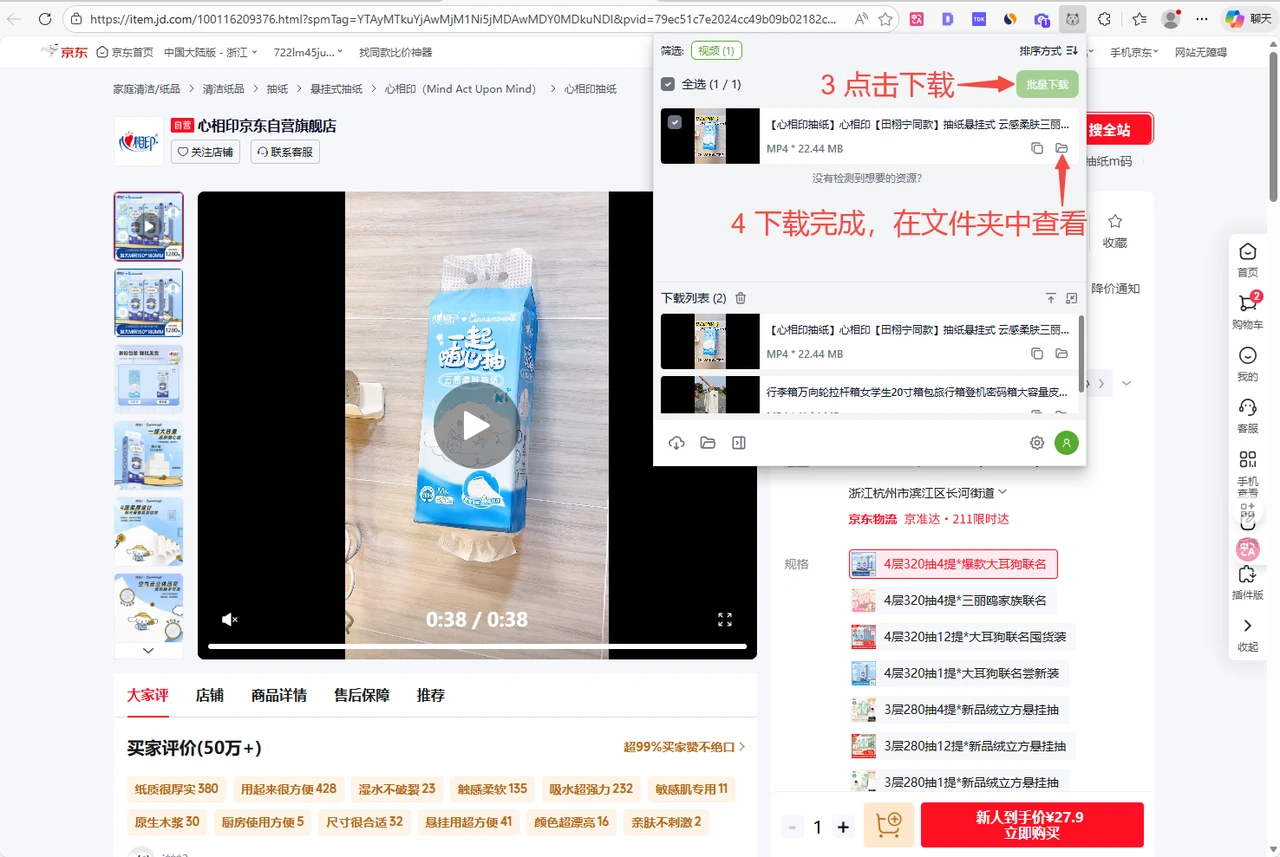
**第一步**:在浏览器中打开商品页面,插件会自动识别页面中的视频资源。
**第二步**:点击浏览器右上角的哼哼猫图标,在弹出面板中可以看到识别到的视频列表。
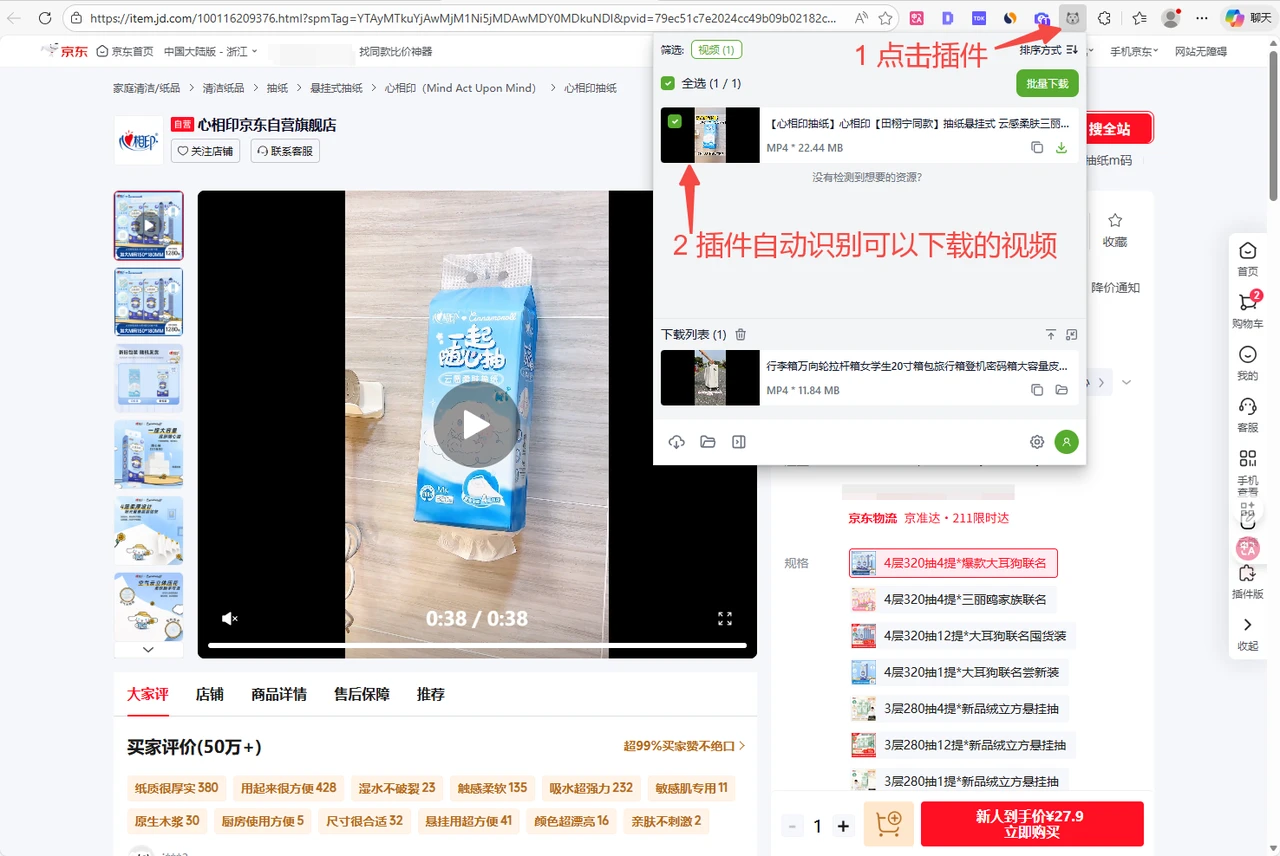
**第三步**:勾选需要的视频,点击 **批量下载** 按钮。
**第四步**:下载完成后,点击文件夹图标即可查看保存的视频。
## 适用平台
该方法适用于所有主流电商平台,包括但不限于:
- **国内**:京东、淘宝、天猫、拼多多、1688、抖音商城
- **海外**:亚马逊(Amazon)、速卖通(AliExpress)、eBay、Shopee
同样也适用于其他任何包含视频的网页,如新闻网站、社交媒体、在线课程等。
---
# 如何下载 1688 上的商品视频
> 使用哼哼猫浏览器插件一键下载 1688 商品视频,无需录屏即可获取高清原视频。支持 Chrome 和 Edge 浏览器,自动嗅探网页中的视频资源,操作简单,一分钟轻松搞定。
来源: https://docs.henghengmao.com/docs/browser-extension/download-1688-product-videos
做电商的朋友肯定遇到过这个问题:在 1688 看到一个不错的商品视频,想保存下来做素材,右键点击却发现没有「另存为」的选项。
用手机对着屏幕录屏?画质模糊、杂音多、还有按钮遮挡,效果很差。
其实只需要一个浏览器插件,就能一键下载高清原视频。
## 安装哼哼猫浏览器插件
在浏览器应用商店安装哼哼猫插件:
- **Chrome 浏览器**:[Chrome 应用商店安装](https://chromewebstore.google.com/detail/meowload-videoliveaudioim/gnplpcfnikehohdgnfnfcienljcbaogj)
- **Edge / 夸克浏览器**:[Edge 应用商店安装](https://microsoftedge.microsoft.com/addons/detail/meowload-videoliveaud/mfmeocjfdcmipdcebfdgpncpmcddmech)
> 详细安装步骤请参考 [安装哼哼猫浏览器插件](https://docs.henghengmao.com/docs/browser-extension/install-meowload-extension)。
## 下载商品视频
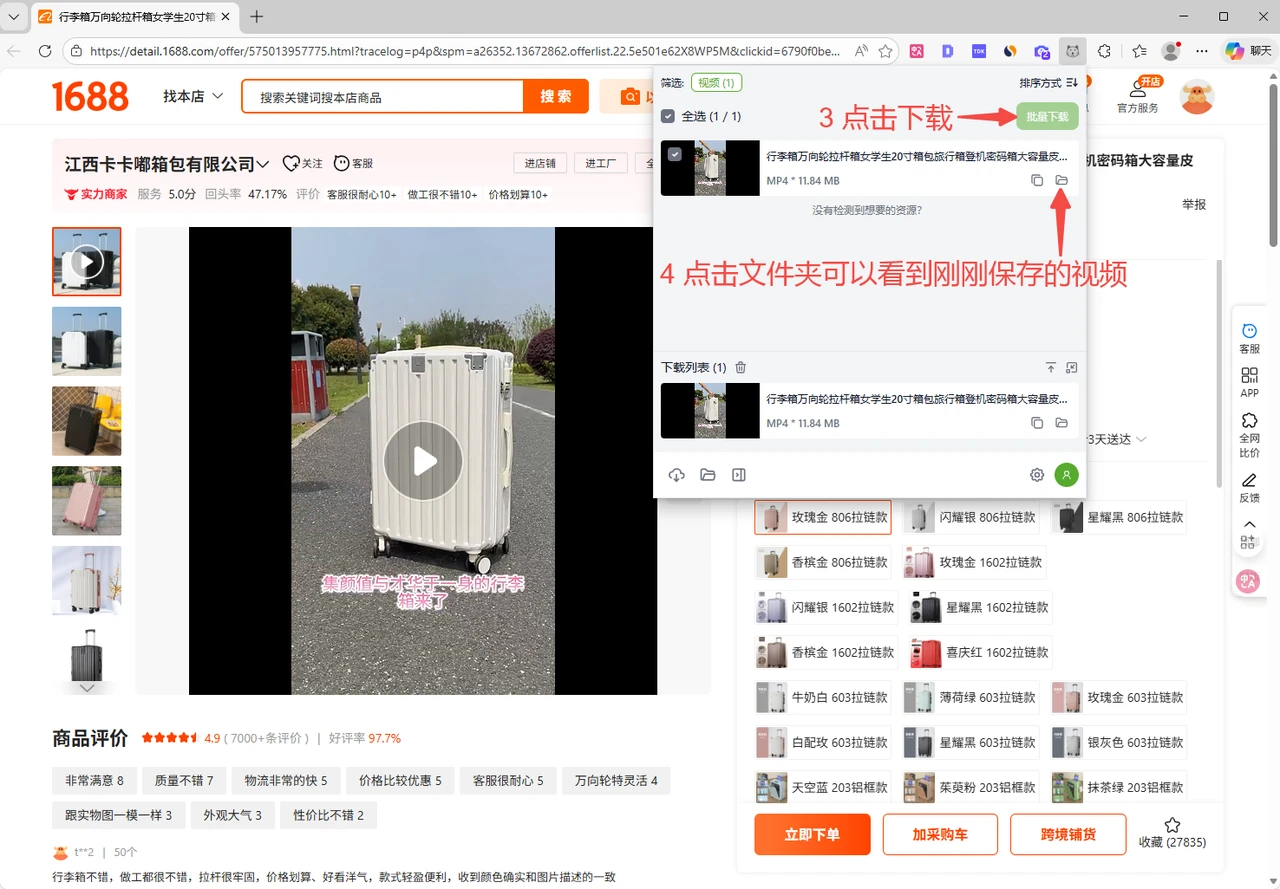
安装好插件后,打开 1688 商品页面,插件会自动识别页面中的视频资源。点击哼哼猫图标即可查看嗅探到的视频。
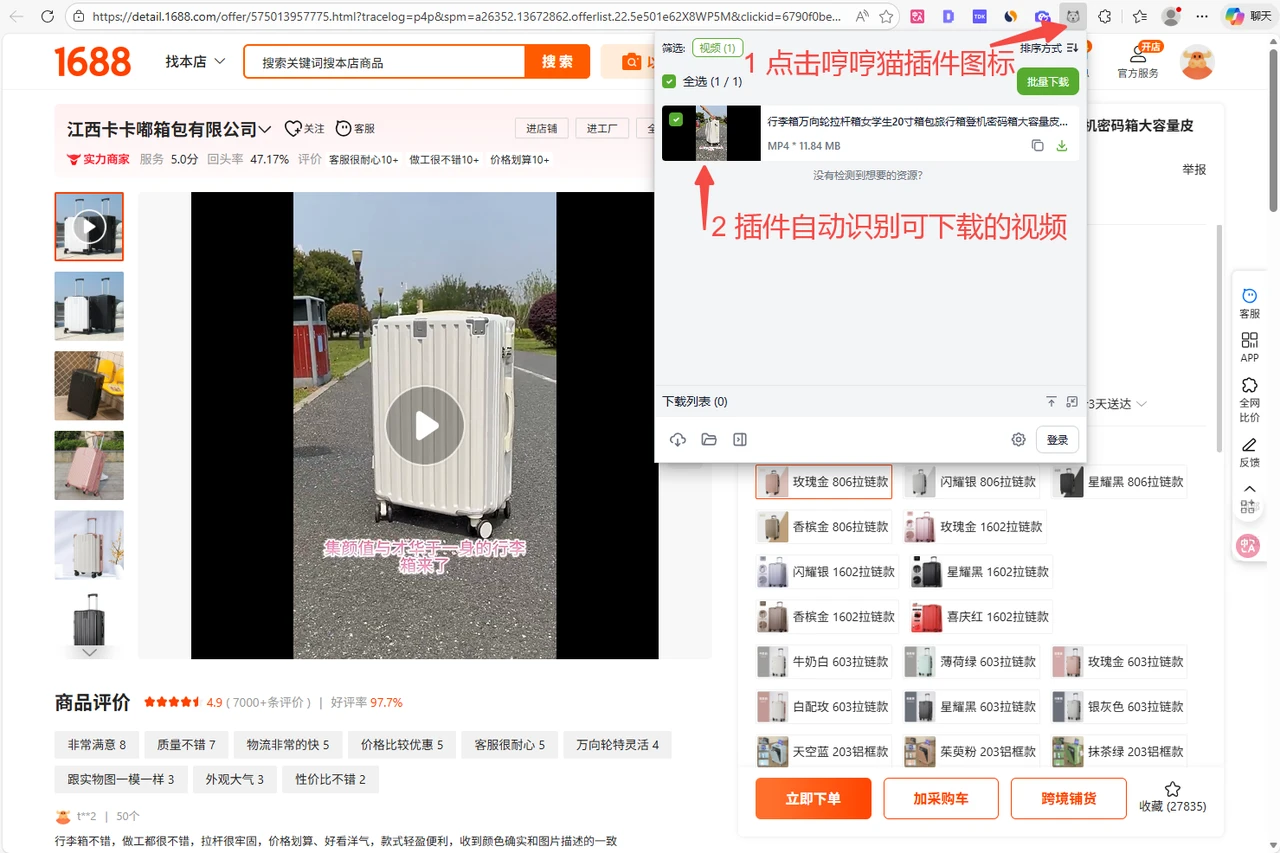
点击 **下载** 按钮,下载完成后点击文件夹图标即可查看保存的视频。
---
# 如何下载微信公众号文章中的视频
> 使用哼哼猫浏览器插件轻松下载微信公众号文章中的视频。只需在浏览器中打开文章页面,插件自动识别视频资源,一键下载保存到本地,无需录屏,画质清晰无损。
来源: https://docs.henghengmao.com/docs/browser-extension/download-wechat-article-videos
微信公众号文章中经常嵌入视频内容,但微信并没有提供直接下载的入口。使用哼哼猫浏览器插件,可以自动识别文章中的视频并一键下载到本地。
## 安装哼哼猫浏览器插件
如果还没有安装插件,请先前往应用商店安装:
- **Chrome 浏览器**:[Chrome 应用商店安装](https://chromewebstore.google.com/detail/meowload-videoliveaudioim/gnplpcfnikehohdgnfnfcienljcbaogj)
- **Edge / 夸克浏览器**:[Edge 应用商店安装](https://microsoftedge.microsoft.com/addons/detail/meowload-videoliveaud/mfmeocjfdcmipdcebfdgpncpmcddmech)
> 详细安装步骤请参考 [安装哼哼猫浏览器插件](https://docs.henghengmao.com/docs/browser-extension/install-meowload-extension)。
## 下载公众号文章中的视频
1. 在浏览器中打开微信公众号文章链接,例如:`https://mp.weixin.qq.com/s/v0OiILpavyPe4PDHaqf_KQ`
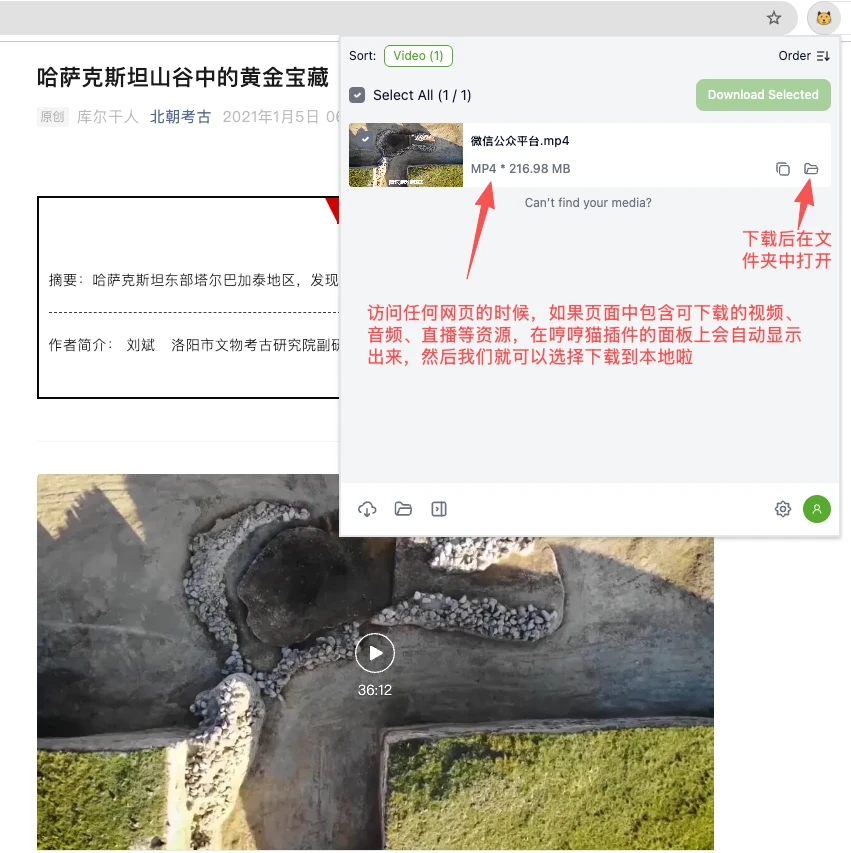
2. 页面加载后,哼哼猫插件会自动识别文章中的视频资源。当插件图标点亮时,说明检测到了可下载的内容。
3. 点击哼哼猫插件图标,在弹出面板中可以看到识别到的视频,选择视频下载即可。下载完成后点击文件夹图标查看保存的视频。
---
# 如何批量保存小红书作者主页的视频、图片和文案?
> 使用哼哼猫浏览器插件,一键批量下载小红书博主主页的无水印视频、高清原图和笔记文案,支持首页和搜索结果页面,告别逐个手动保存,彻底解放双手。
来源: https://docs.henghengmao.com/docs/browser-extension/batch-save-xiaohongshu-notes
刷小红书时看到绝美壁纸想保存,却发现右下角有水印?遇到喜欢的博主想把 TA 主页的视频存下来慢慢看,却只能一个个手动保存,甚至还在用录屏?
今天教大家一个高效的方法:使用 [哼哼猫](https://www.henghengmao.com/universal-media-downloader) 浏览器插件,不仅能保存高清无水印的原图,还能一键批量下载博主主页的所有视频、图片和文案,彻底解放双手!
## 前提条件
在电脑浏览器(Chrome / Edge)上打开小红书网页版,使用哼哼猫插件即可一键下载。如果浏览器尚未安装哼哼猫插件,请先参考 [安装教程](https://docs.henghengmao.com/docs/browser-extension/install-meowload-extension) 完成安装。
## 操作步骤
### 第一步:打开博主主页
在小红书网页版中,进入你想保存内容的博主主页。
### 第二步:等待插件自动识别
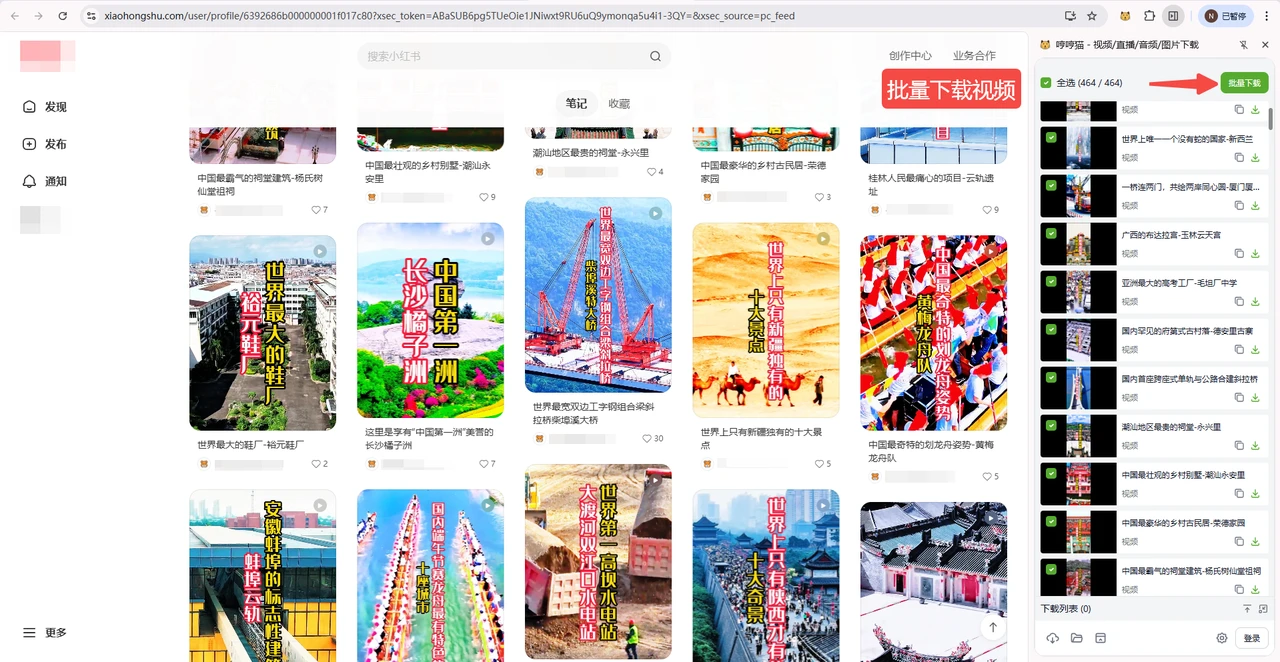
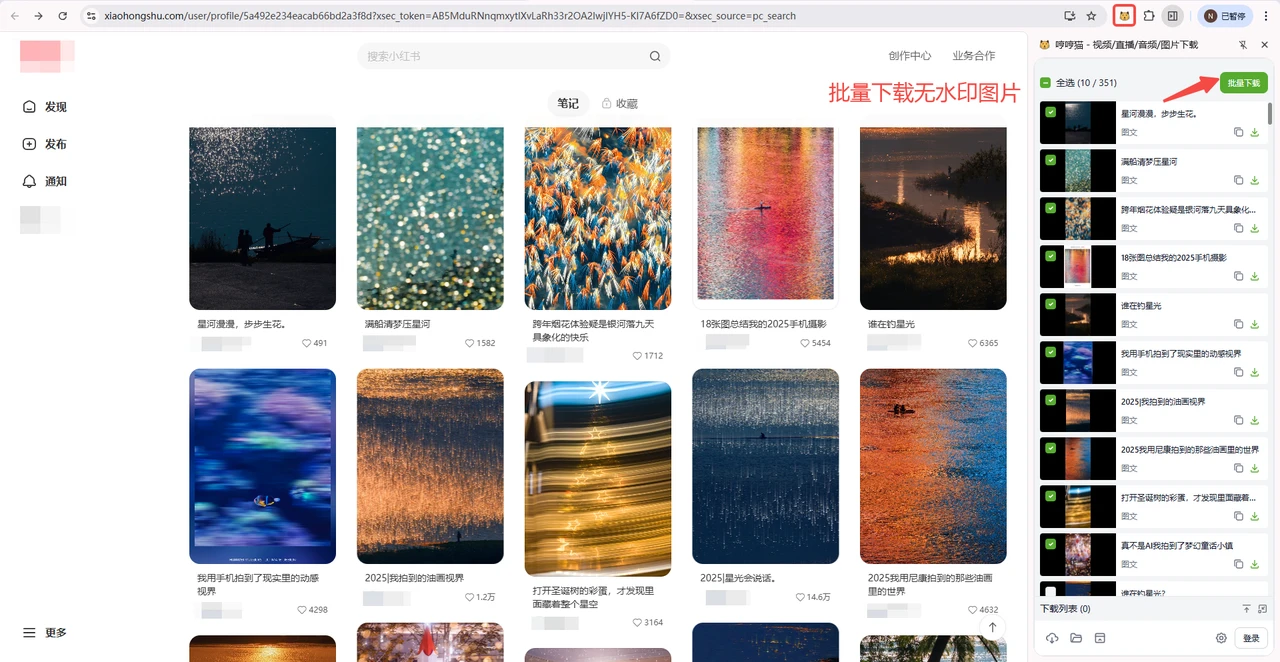
打开哼哼猫插件面板,插件会自动识别当前页面中加载的所有视频和图文笔记。
### 第三步:滚动页面加载更多内容
如果需要保存博主的全部笔记,请将页面**持续向下滚动**直到底部。滚动过程中,你会看到插件面板中识别到的资源数量不断增加。滚动到底部后,插件就能识别到博主的所有笔记内容。
### 第四步:全选并批量下载
在插件面板中点击**全选**,然后点击**批量下载**即可。所有视频和图片均为无水印高清原始文件。
## 不只是作者主页
除了博主个人主页之外,在小红书的**首页推荐**和**搜索结果页面**中,同样可以使用哼哼猫插件批量保存页面上显示的所有笔记内容(视频、图片和文案)。
---
# YouTube 字幕下载 - 支持多语言、多种字幕格式
> 详细介绍如何使用哼哼猫下载 YouTube 视频字幕,支持中文、英文等多语言字幕提取,提供 SRT、VTT、TTML、JSON3 等多种格式选择。桌面端和网页端两种方式,操作简单快捷。
来源: https://docs.henghengmao.com/docs/youtube/youtube-subtitles-download
观看 YouTube 视频时,字幕对于语言学习、内容理解和二次创作都非常重要。哼哼猫提供了**两种便捷的方式**下载 YouTube 字幕,支持多种语言和格式,满足不同场景的需求。
## 📥 方式一:桌面软件下载字幕(推荐 SRT 格式)
### 操作步骤
1. **复制视频链接**:在 YouTube 上找到想要下载字幕的视频,复制视频分享链接(例如:`https://youtu.be/Ah_uuTwGOYU`)
2. **打开哼哼猫软件**:启动哼哼猫桌面软件,在左侧菜单选择「**链接下载**」功能
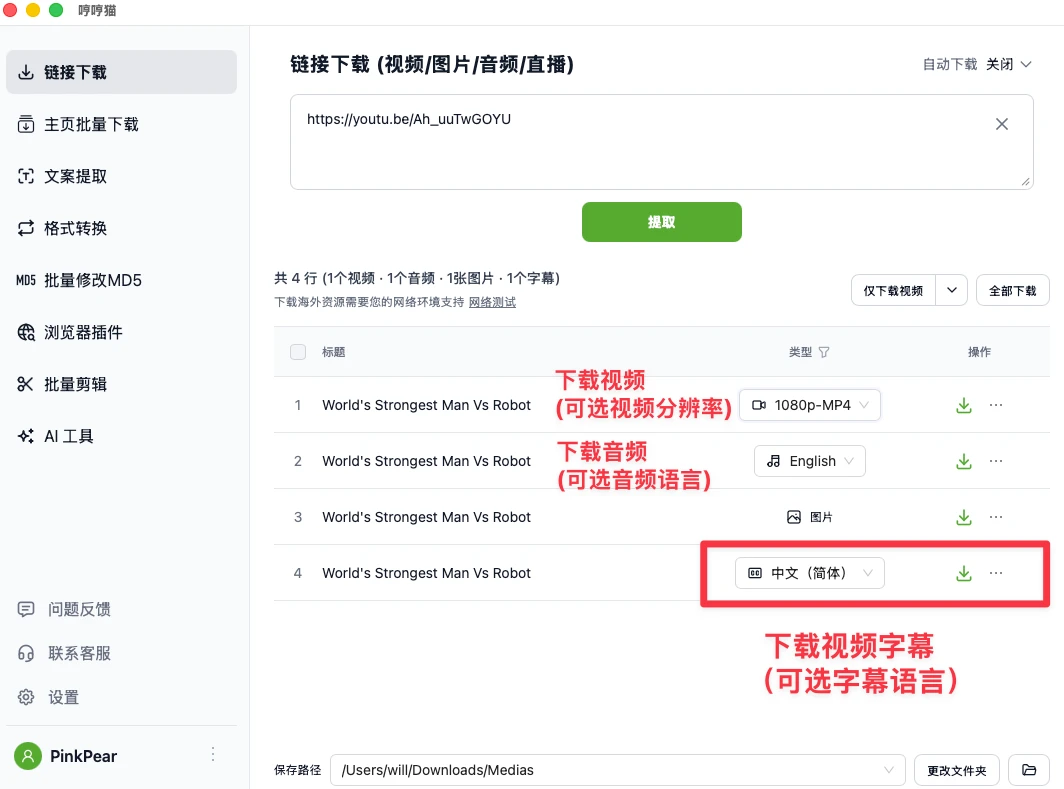
3. **粘贴链接并提取**:将复制的 YouTube 链接粘贴到输入框中,点击绿色的「**提取**」按钮
4. **选择字幕语言下载**:如果视频包含字幕,提取结果列表中会显示字幕下载选项。点击字幕行右侧的语言下拉菜单,选择你需要的语言(如中文简体、英文等),然后点击下载按钮即可
 ### 方式一特点
- **操作简单**:与下载视频、音频、图片流程一致,可以同时下载视频、音频、图片和字幕
- **默认 SRT 格式**:下载的字幕为通用的 SRT 格式,兼容性最好
- **格式限制**:仅支持 SRT 格式,如需其他格式请使用方式二
---
## 🌐 方式二:网页端下载字幕(支持多种格式)
### 操作步骤
1. **访问网页工具**:打开哼哼猫网页端的 [**YouTube 视频字幕下载功能**](https://www.henghengmao.com/youtube-subtitle-downloader)
2. **粘贴链接并提取**:将 YouTube 视频分享链接粘贴到输入框中,点击「**单个链接提取**」按钮
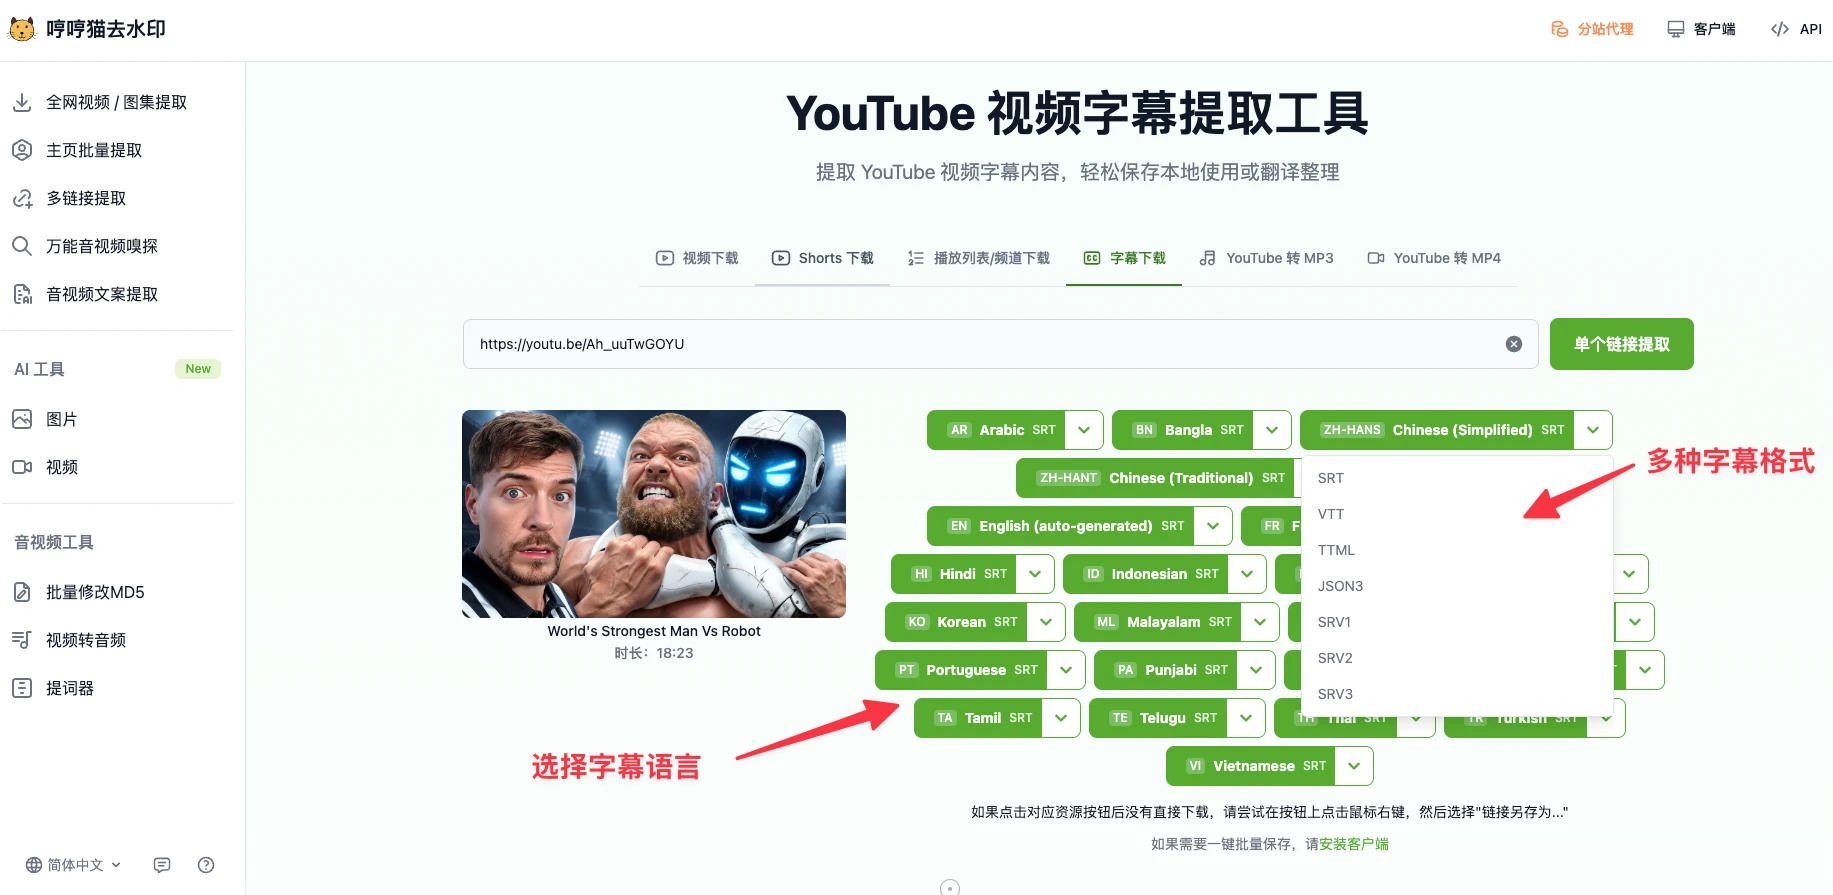
3. **选择语言和格式**:提取成功后,页面会显示该视频的所有可用语言字幕。每个语言右侧都有:**格式下拉菜单**:点击语言标签右侧的下拉按钮,可以选择字幕格式
4. **下载字幕**:选择好语言和格式后,点击下载按钮即可保存到本地
 ### 支持的字幕格式
| 格式 | 说明 | 适用场景 |
| ------------------ | -------------- | ----------------- |
| **SRT** | 最通用的字幕格式 | 视频编辑软件、播放器、字幕翻译工具 |
| **VTT** | Web 视频字幕标准格式 | 网页播放器、HTML5 视频 |
| **TTML** | 时序文本标记语言 | 专业视频制作、广播电视 |
| **JSON3** | JSON 格式的字幕数据 | 开发者、数据分析、程序处理 |
| **SRV1/SRV2/SRV3** | YouTube 原始字幕格式 | 特殊需求、格式研究 |
### 方式二特点
- **格式丰富**:支持 SRT/VTT/TTML/JSON3/SRV1/SRV2/SRV3 等多种格式
- **无需安装**:网页端使用,任何设备都可访问
---
### 常见问题
**Q:如果视频没有字幕怎么办?**
A:部分视频可能没有上传字幕,这种情况下提取结果中不会显示字幕选项。您可以尝试查看视频是否有自动生成的字幕(auto-generated)。
**Q:下载的字幕是中英双语的吗?**
A:下载的是单一语言字幕。如需双语字幕,可以分别下载两种语言,然后使用字幕编辑工具合并。
**Q:字幕文件如何使用?**
A:下载的 SRT 字幕可以在视频播放器(如 VLC、PotPlayer)中加载,也可以导入视频编辑软件(如 PR、剪映)使用。
---
# 使用哼哼猫浏览器插件下载 YouTube 视频
> 使用客户端下载 YouTube 视频遇到 403 错误?本文详细介绍如何通过哼哼猫浏览器插件轻松下载 YouTube 视频,包含完整的安装步骤、操作指南及常见问题解决方案,助您快速保存高清视频。
来源: https://docs.henghengmao.com/docs/youtube/download-youtube-with-meowload-browser-extension
## 问题背景
使用客户端下载 YouTube 视频时,部分用户反馈遇到 **403 错误**。这通常是由于网络限制或 YouTube 的防爬虫机制导致的。
使用哼哼猫浏览器插件可以有效绕过这些限制,提供更稳定的下载体验。此外,浏览器插件方式还支持下载 **年龄限制视频** 和 **地区限制视频**。
## 浏览器插件下载 YouTube 操作步骤
### 1️⃣ 安装浏览器插件
如果浏览器尚未安装哼哼猫插件,请先参考 [安装教程](https://docs.henghengmao.com/docs/browser-extension/install-meowload-extension) 完成安装。
### 2️⃣ 访问 YouTube 视频
在浏览器中正常访问要下载的 YouTube 视频页面。
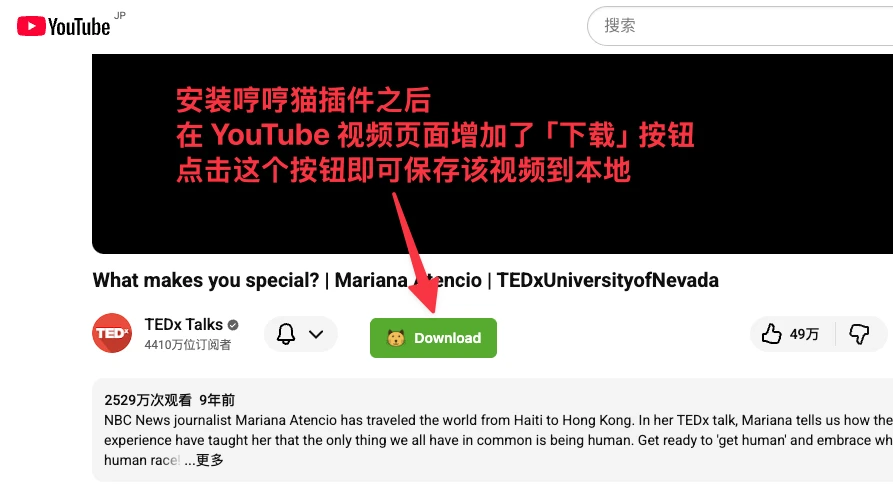
### 3️⃣ 点击下载按钮
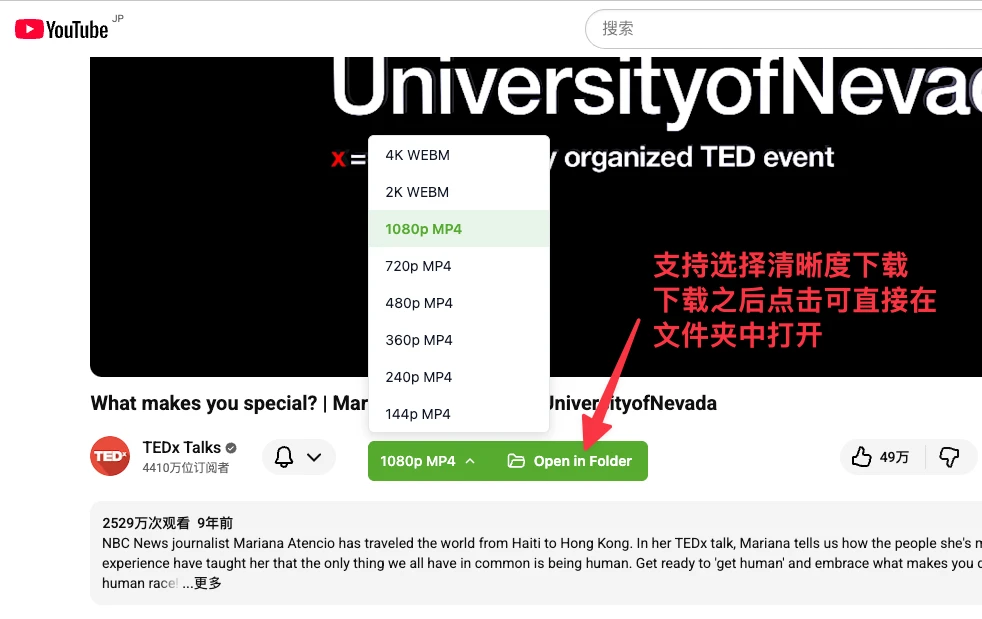
视频页面加载完成后,您会看到哼哼猫插件的 **下载按钮**。**点击下载按钮** → 选择视频质量和格式 → 确认下载。
 ### 4️⃣ 等待下载完成
插件会自动将视频保存到您在浏览器插件内配置的下载文件夹。
 ## 常见问题
### ❓ 下载后的视频无法播放
**原因**:可能是浏览器或系统缺少相应的视频解码器。
**解决方案**:
- 确保选择了 MP4 格式(最兼容)
- 在系统中安装完整的视频解码器
- 尝试使用其他视频播放器打开
### ❓ 找不到下载按钮
**原因**:插件可能未正确加载或需要刷新。
**解决方案**:
- 刷新页面(F5 或 Ctrl+R)
- 检查插件是否已启用(浏览器扩展管理中)
- 尝试重启浏览器
- 更新插件到最新版本
---
# 如何下载 YouTube 播放列表
> 使用哼哼猫将 YouTube 播放列表批量下载到电脑。本文详细介绍从复制链接到批量下载的完整步骤,支持多种格式和高清分辨率。
来源: https://docs.henghengmao.com/docs/youtube/how-to-download-a-youtube-playlist
YouTube 上有数百万个播放列表,涵盖音乐专辑、教学系列、精选合集等各类主题。将整个播放列表保存到本地,方便离线观看、学习或个人收藏。
通过 **[哼哼猫](https://www.henghengmao.com/app)**,你可以将完整的 YouTube 播放列表批量下载到电脑,支持多种格式和分辨率(包括高清)。操作步骤如下:
1. **安装桌面客户端**
下载并安装 **[哼哼猫](https://www.henghengmao.com/app)**,支持 Windows 和 macOS。
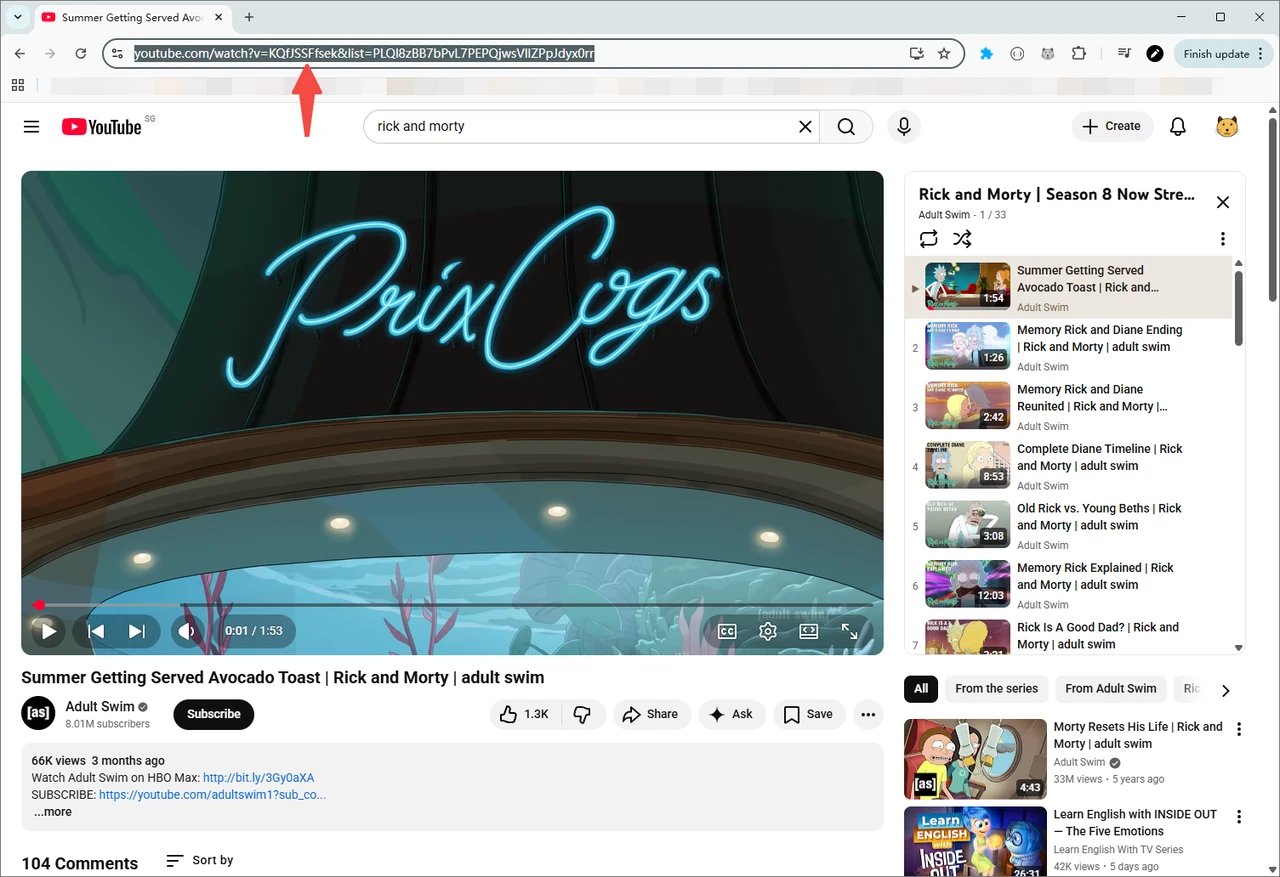
2. **复制播放列表链接**
在浏览器中打开 YouTube 播放列表,从地址栏复制其 URL。
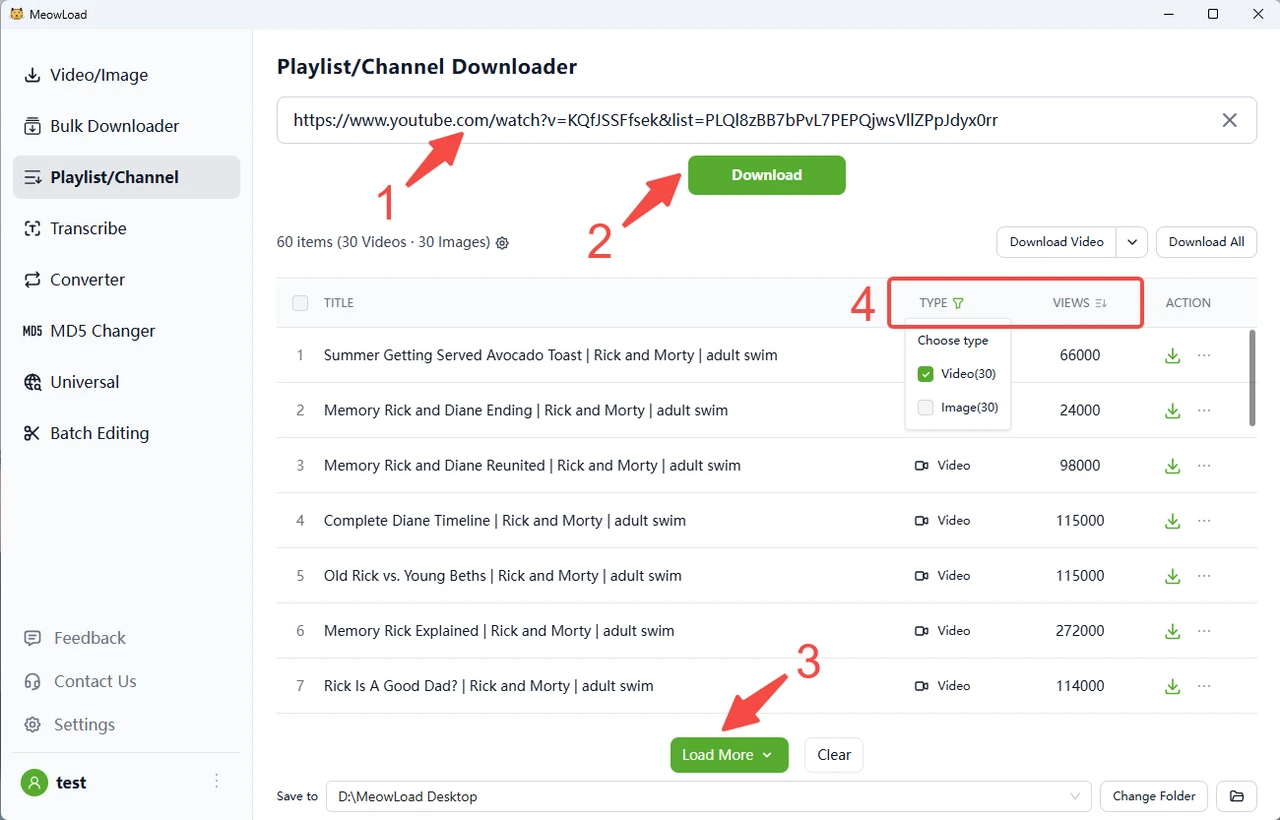
3. **粘贴链接并点击下载**
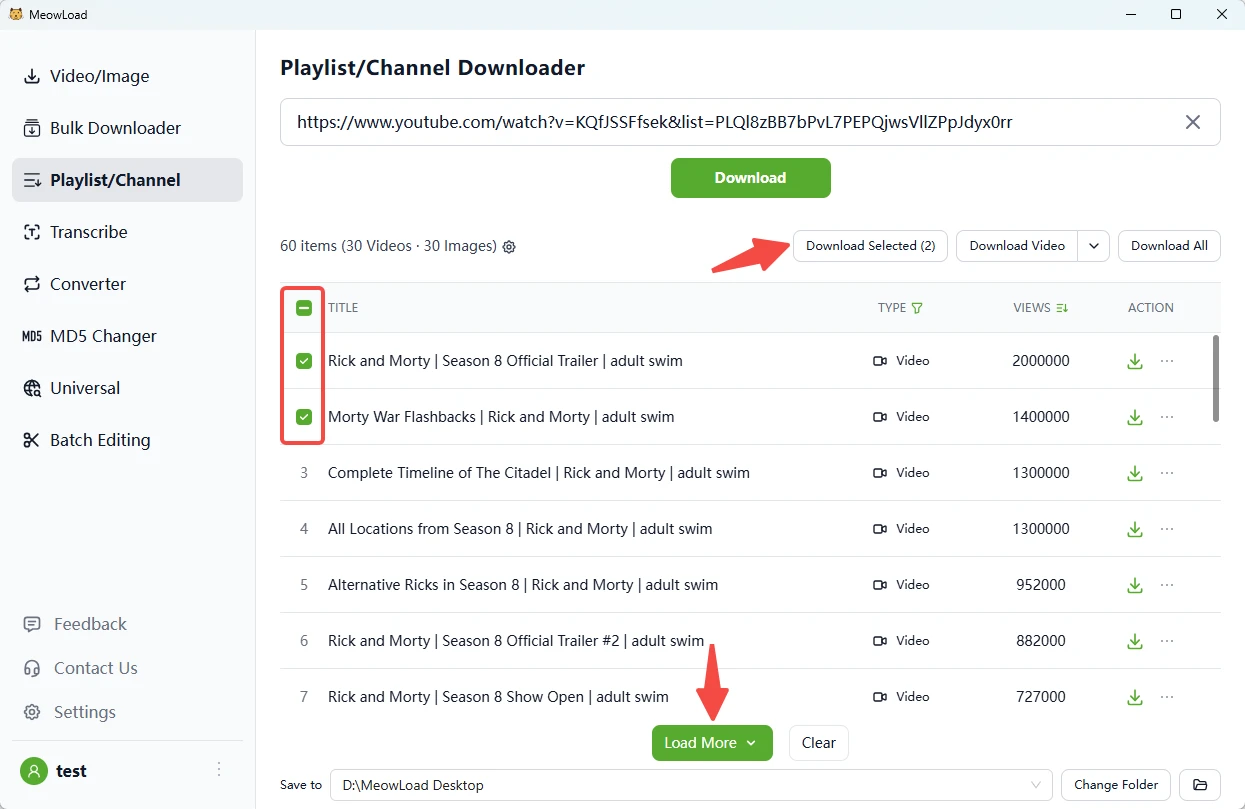
粘贴链接后可以预览媒体资源。
4. **加载更多并筛选内容**
点击 **加载更多** 获取更多视频。你可以按播放量或点赞数排序,也可以使用筛选器选择需要的类型。
5. **选择需要下载的项目**
全选或勾选需要的项目,然后点击 **下载所选**。
6. **完成!**
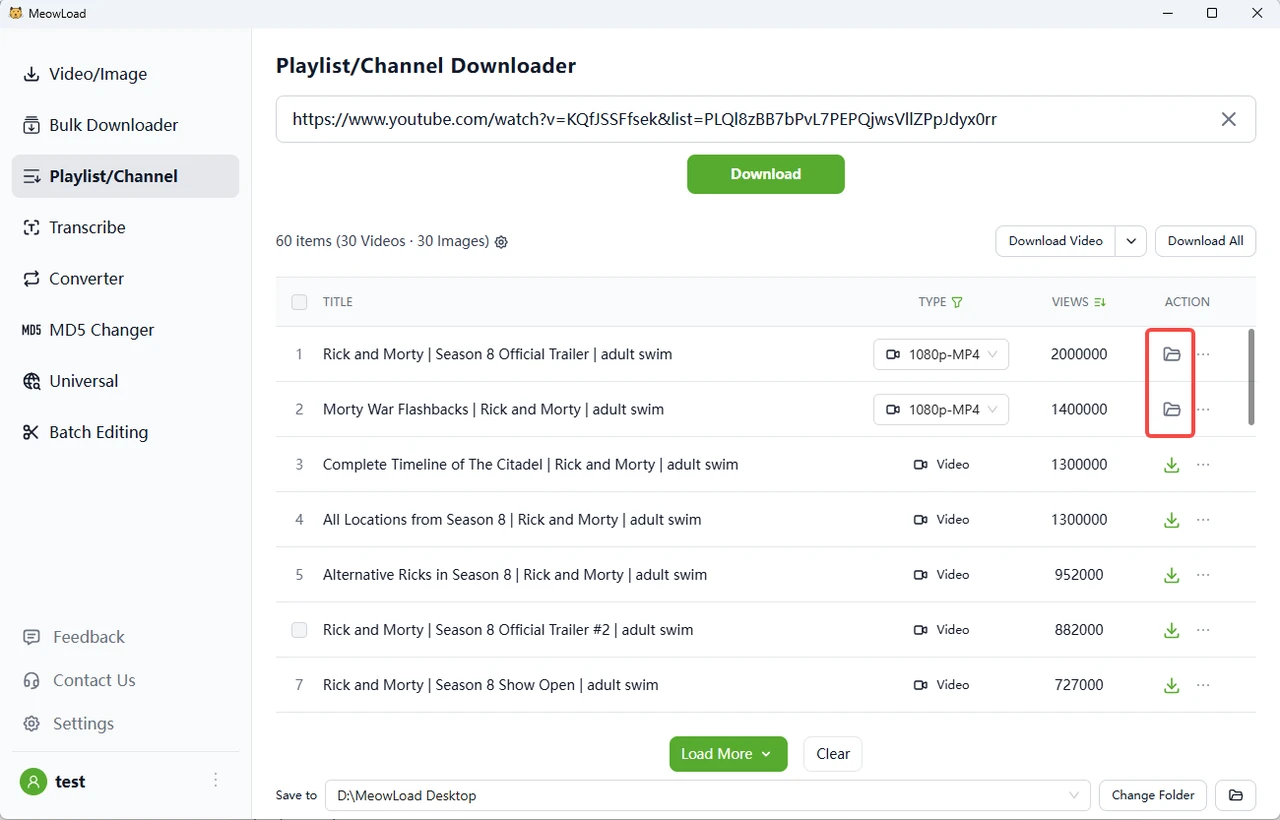
下载完成后,点击文件夹图标即可查看已下载的文件。
---
# 下载 YouTube 视频时遇到网络问题怎么解决?
> 使用哼哼猫下载YouTube等国外资源时遇到请求超时、网络连接异常等错误?本文介绍如何通过内置网络测试功能排查问题,并配置代理解决网络无法访问的问题。
来源: https://docs.henghengmao.com/docs/youtube/youtube-network-troubleshooting
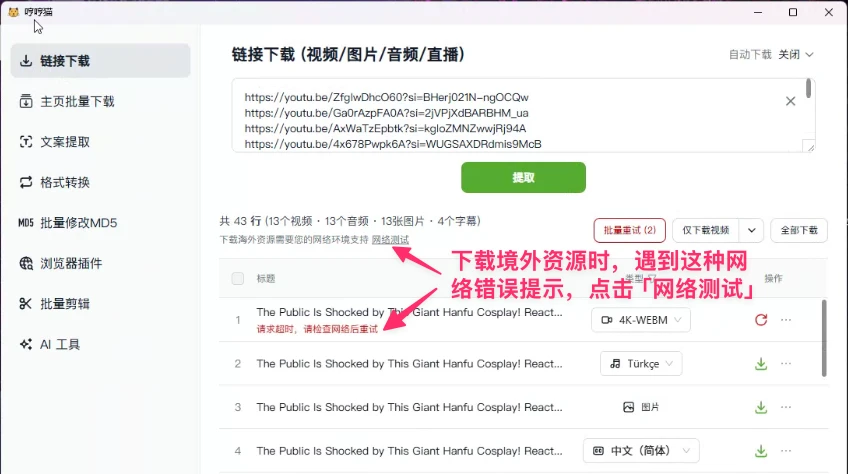
使用 [哼哼猫](https://www.henghengmao.com/app) 电脑版下载 YouTube、Instagram、Twitter 等平台的资源时,如果遇到以下错误提示:
- **请求超时**
- **网络连接异常**
- **连接超时**
通常是因为电脑的网络环境无法直接访问这些网站。请按照以下步骤排查和解决。
## 第一步:使用网络测试功能
在下载页面中,点击提示信息旁的 **「网络测试」** 链接,软件会自动打开 "设置 - 网络" 页面,并检测当前网络环境到各主要网站的连通性。
## 第二步:查看测试结果
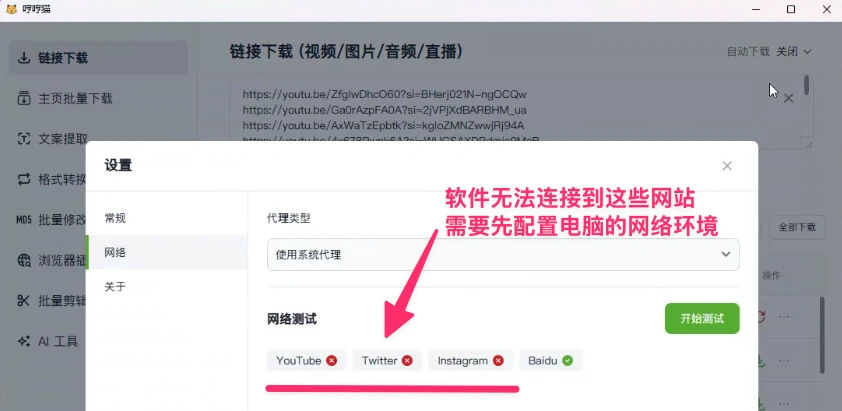
在设置页面的 **「网络」** 选项卡中,点击 **「开始测试」** 按钮,软件会逐一测试到 YouTube、Twitter、Instagram、Baidu 等网站的连通性。
- ✅ 表示可以正常连接
- ❌ 表示无法连接
如果 YouTube、Twitter 等网站显示 ❌,说明当前网络环境无法访问这些网站,可能需要配置代理。
## 第三步:配置代理
哼哼猫默认使用 **「系统代理」** 模式,即跟随操作系统的代理设置。请确认:
1. **电脑上已安装并开启了代理工具**
2. **代理工具已开启「系统代理」模式**,使系统全局流量通过代理
3. 配置完成后,回到哼哼猫的网络测试页面,重新点击 **「开始测试」** ,确认网站连通性测试全部通过 ✅
> **提示**:如果代理工具已开启但测试仍然失败,请检查代理工具是否正常工作(可以尝试在浏览器中打开 YouTube 来验证),或者尝试切换代理节点。
## 配置了代理但还是下载失败?
- 检查代理工具是否开启了 **「系统代理」** 模式(而非仅规则模式)
- 尝试切换代理节点后重新测试
- 确认代理工具本身可以正常访问 YouTube(用浏览器验证)
---
# MeowLoad CLI 命令行工具
> 哼哼猫命令行工具(MeowLoad CLI)让你在终端中快速下载视频、音频、图片、直播流、字幕等多媒体资源,支持 1000+ 网站,适用于 macOS 和 Windows。
来源: https://docs.henghengmao.com/cli
哼哼猫自 **v3.9.9** 版本起新增了命令行工具 `meowload`,让你可以直接在终端中下载视频、音频、图片、直播流、字幕等资源,适合喜欢命令行操作或需要在脚本中集成下载能力的用户。
## 工作原理
`meowload` CLI 通过与哼哼猫桌面软件通信来执行任务。当你在终端执行 `info` 或 `download` 命令时,CLI 会自动启动桌面软件(如果软件未启动),并由桌面软件完成资源的解析和下载。
> [!NOTE]
>
> CLI 需要搭配哼哼猫桌面软件使用,使用前请确保已在桌面软件中登录账号。
## 系统要求
| 系统 | 支持情况 |
| --- | --- |
| macOS | ✅ 支持 |
| Windows | ✅ 支持 |
CLI 随桌面软件一起安装,无需单独下载。如果你还没有安装哼哼猫桌面软件,请前往 [下载页面](https://www.henghengmao.com/app) 获取。
## 验证安装
安装桌面软件后,打开终端输入以下命令,确认 CLI 已正确安装:
```bash
meowload version
```
如果安装成功,会输出当前桌面软件版本号:
```json
{"version":"3.9.9"}
```
## 快速上手
### 下载资源
使用 `download` 命令下载链接中的所有媒体资源:
```bash
meowload download https://www.youtube.com/watch?v=dQw4w9WgXcQ
```
只下载视频:
```bash
meowload download https://www.youtube.com/watch?v=dQw4w9WgXcQ --media_type video
```
只下载音频和图片:
```bash
meowload download https://www.youtube.com/watch?v=dQw4w9WgXcQ --media_type audio,image
```
### 查询资源信息
使用 `info` 命令查看某个链接包含的媒体资源:
```bash
meowload info https://www.youtube.com/watch?v=dQw4w9WgXcQ
```
## 命令列表
| 命令 | 说明 |
| --- | --- |
| [`meowload download`](https://docs.henghengmao.com/cli/download) | 下载链接中的媒体资源 |
| [`meowload info`](https://docs.henghengmao.com/cli/info) | 查询链接中可用的媒体资源 |
| [`meowload convert`](https://docs.henghengmao.com/cli/convert) | 转换媒体文件格式(视频/音频/图片) |
| [`meowload md5`](https://docs.henghengmao.com/cli/md5) | 修改文件的 MD5 哈希值 |
| [`meowload completion`](https://docs.henghengmao.com/cli/completion) | 生成 Shell 自动补全脚本 |
| `meowload version` | 查看当前版本号 |
| `meowload help` | 查看帮助信息 |
---
# meowload download
> 使用 meowload download 命令一键下载 YouTube、B站、抖音等 1000+ 平台的视频、音频、图片、直播流和字幕,支持按媒体类型筛选,轻松集成到自动化脚本中。
来源: https://docs.henghengmao.com/cli/download
从指定帖子链接下载媒体资源。默认下载链接中包含的所有类型资源(视频、音频、图片、直播流、字幕等)。
## 用法
```bash
meowload download [flags]
```
## 参数
| 参数 | 说明 |
| ------- | -------------- |
| `` | 要下载的帖子链接地址(必填) |
## Flags
| Flag | 类型 | 默认值 | 说明 |
| -------------- | ------ | ---- | --------------------- |
| `--media_type` | string | 全部类型 | 按媒体类型筛选下载,多个类型用英文逗号分隔 |
| `-h, --help` | | | 查看帮助信息 |
### 媒体类型说明
`--media_type` 支持以下值:
| 类型 | 说明 |
| --- | --- |
| `video` | 视频 |
| `audio` | 音频 |
| `image` | 图片 |
| `live` | 直播流 |
| `subtitle` | 字幕 |
可以用英文逗号组合多个类型,例如 `--media_type video,audio`。
## 示例
### 下载所有资源
```bash
meowload download https://www.youtube.com/watch?v=xxxx
```
默认下载该链接中包含的所有类型媒体资源。
### 只下载视频
```bash
meowload download https://www.youtube.com/watch?v=xxxx --media_type video
```
### 只下载音频和图片
```bash
meowload download https://www.youtube.com/watch?v=xxxx --media_type audio,image
```
> [!TIP]
>
> 如果不确定链接中包含哪些资源类型,可以先使用 [`meowload info`](https://docs.henghengmao.com/cli/info) 命令查看。
---
# meowload info
> 使用 meowload info 命令查看帖子链接中包含的视频、音频、图片、字幕等可下载资源列表,支持 1000+ 平台,下载前快速预览可用资源和格式信息。
来源: https://docs.henghengmao.com/cli/info
查询指定帖子链接中可下载的媒体资源列表,包括视频、音频、图片、字幕、直播流等。可以在下载之前先用此命令了解帖子包含哪些资源。
## 用法
```bash
meowload info
```
## 参数
| 参数 | 说明 |
| ------- | -------------- |
| `` | 要查询的帖子链接地址(必填) |
## Flags
| Flag | 说明 |
| --- | --- |
| `-h, --help` | 查看帮助信息 |
## 示例
```bash
meowload info https://www.youtube.com/watch?v=dQw4w9WgXcQ
```
> [!TIP]
>
> 确认资源信息后,可以使用 [`meowload download`](https://docs.henghengmao.com/cli/download) 命令下载所需的资源。
---
# meowload convert
> 使用 meowload convert 命令批量转换媒体文件格式,支持视频转音频、HEIC 转 JPG、AVIF 转 PNG 等跨类型转换,覆盖 50+ 输出格式,一行命令搞定格式兼容问题。
来源: https://docs.henghengmao.com/cli/convert
批量转换媒体文件格式。支持视频、音频、图片之间的任意转换,比如从视频中提取音频、将 HEIC 转为 JPG、AVIF 转为 PNG 等。
## 亮点
- 跨类型转换:视频 → 音频、图片 → 图片、视频 → 视频,随意组合
- 支持新格式:AVIF、HEIC、HEIF、WebP 等现代格式互转
- 批量处理:一次传入多个文件,批量完成转换
- 任意输入格式:不限制输入文件格式,只要是媒体文件都能识别
- 自定义输出目录:通过 `--output-dir` 指定输出位置,保持文件整洁
## 用法
```bash
meowload convert ... [flags]
```
## Flags
| Flag | 类型 | 默认值 | 说明 |
| --- | --- | --- | --- |
| `--to` | string | | 目标格式,如 mp3、mp4、png(必填) |
| `--output-dir` | string | 与输入文件相同目录 | 输出目录 |
| `-h, --help` | | | 查看帮助信息 |
## 支持的输出格式
### 视频
MP4、MKV、MOV、WEBM、AVI、FLV、TS、MPG、MPEG、WMV、OGV、3GP、SWF、VOB、3G2
### 音频
MP3、AAC、M4A、WAV、FLAC、OPUS、OGG、OGA、AIF、AIFF、WMA、ALAC、M4R(iPhone 铃声)、MP2、AMR、MMF
### 图片
JPEG、JPG、PNG、BMP、TIFF、WebP、GIF、TGA、AVIF、EXR、ICO、HEIC、HEICS、HEIF、HEIFS、HIF
> [!TIP]
>
> 以上仅列出部分常用格式,实际支持的输出格式更多。输入格式不受限制,任何可识别的媒体文件都可以作为输入文件。
## 示例
### 视频转 MP4
```bash
meowload convert video.mkv --to mp4
```
### 视频提取音频
```bash
meowload convert video.mp4 --to mp3
```
### HEIC 转 JPG
```bash
meowload convert photo.heic --to jpg
```
### AVIF 转 PNG
```bash
meowload convert image.avif --to png
```
### 批量转换图片为 WebP
```bash
meowload convert *.png --to webp
```
### 指定输出目录
```bash
meowload convert *.heic --to jpg --output-dir ~/Pictures/converted
```
---
# meowload md5
> 使用 meowload md5 命令一键批量修改文件的 MD5 哈希值,避免平台查重检测,操作简单高效,支持任意文件类型。
来源: https://docs.henghengmao.com/cli/md5
复制文件并修改 MD5 哈希值,用于避免平台的重复内容检测。
## 亮点
- 一键操作:传入文件即可完成,无需任何额外配置
- 批量处理:支持同时处理多个文件,高效省时
- 不限文件类型:视频、音频、图片等任意文件都可以处理
- 非破坏性:生成新文件,不修改原始文件
## 用法
```bash
meowload md5 ... [flags]
```
## Flags
| Flag | 说明 |
| --- | --- |
| `-h, --help` | 查看帮助信息 |
## 示例
### 修改单个文件
```bash
meowload md5 video.mp4
```
输出文件会在同目录下生成,文件名带有 `[MD5]` 前缀。
### 批量修改多个文件
```bash
meowload md5 video1.mp4 video2.mp4 photo.jpg
```
### 配合通配符批量处理
```bash
meowload md5 *.mp4
```
---
# Shell 自动补全
> 为 meowload 命令行工具配置 Shell 自动补全功能,输入命令时按 Tab 键即可补全子命令和参数,支持 Zsh、Bash、Fish 和 PowerShell。
来源: https://docs.henghengmao.com/cli/completion
`meowload` 支持为常用 Shell 生成自动补全脚本,让你在输入命令时可以使用 `Tab` 键自动补全子命令和参数。
## 支持的 Shell
- Bash
- Zsh
- Fish
- PowerShell
---
## Zsh
macOS 默认使用 Zsh。
**在当前会话中临时启用:**
```bash
source <(meowload completion zsh)
```
**永久启用(推荐):**
```bash
meowload completion zsh > $(brew --prefix)/share/zsh/site-functions/_meowload
```
> [!NOTE]
>
> 如果你的环境中尚未启用 Shell 补全功能,需要先执行一次:
> ```bash
> echo "autoload -U compinit; compinit" >> ~/.zshrc
> ```
重新打开终端即可生效。
---
## Bash
**在当前会话中临时启用:**
```bash
source <(meowload completion bash)
```
**永久启用:**
macOS:
```bash
meowload completion bash > $(brew --prefix)/etc/bash_completion.d/meowload
```
Linux:
```bash
meowload completion bash > /etc/bash_completion.d/meowload
```
> [!NOTE]
>
> Bash 自动补全依赖 `bash-completion` 包。如果未安装,可通过包管理器安装:
> ```bash
> # macOS
> brew install bash-completion
> ```
重新打开终端即可生效。
---
## Fish
**在当前会话中临时启用:**
```bash
meowload completion fish | source
```
**永久启用:**
```bash
meowload completion fish > ~/.config/fish/completions/meowload.fish
```
重新打开终端即可生效。
---
## PowerShell
**在当前会话中临时启用:**
```powershell
meowload completion powershell | Out-String | Invoke-Expression
```
**永久启用:**
将上述命令添加到你的 PowerShell 配置文件中。配置文件路径可通过以下命令查看:
```powershell
echo $PROFILE
```
---
# 搭配 Claude Code 使用
> 通过 Anthropic Claude Code 调用 meowload 命令行工具,用对话的方式下载视频、音频、图片、字幕等资源,无需记忆任何命令语法,支持连续对话和多任务操作。
来源: https://docs.henghengmao.com/cli/use-with-claude-code
Claude Code 是 Anthropic 推出的终端 AI 编程代理。它可以直接在你的终端中执行 Shell 命令,这意味着你可以用自然语言让 Claude Code 调用 `meowload` 来下载资源——无需记忆任何命令语法。
## 前提条件
1. 已安装 [MeowLoad 桌面软件](https://www.henghengmao.com/app) (v3.9.9 或更高版本)并已登录账号
2. 已安装 Claude Code
在终端中运行以下命令,确认两者都已就绪:
```bash
meowload version
claude --version
```
## 快速上手
打开终端,启动 Claude Code,直接用自然语言描述你的需求即可:
```
claude "用 meowload 下载这个视频 https://www.youtube.com/watch?v=dQw4w9WgXcQ"
```
Claude Code 会自动识别你的意图,调用 `meowload download` 命令完成下载。
## 提示词示例
以下是一些你可以直接使用的提示词,复制粘贴到 Claude Code 中即可:
### 下载视频
```text
用 meowload 下载这个链接里的视频:https://www.youtube.com/watch?v=xxxx
```
### 只下载音频
```text
用 meowload 只下载音频:https://www.youtube.com/watch?v=xxxx
```
### 下载前先查看资源信息
```text
用 meowload 查看这个链接有哪些可下载的资源:https://www.youtube.com/watch?v=xxxx
如果有视频和字幕,帮我都下载下来
```
### 批量下载多个链接
```text
用 meowload 依次下载以下链接的视频:
1. https://www.instagram.com/reel/xxxx
2. https://www.tiktok.com/@user/video/xxxx
3. https://www.youtube.com/watch?v=xxxx
```
### 下载直播流
```text
用 meowload 录制这个直播:https://www.twitch.tv/xxxx
```
## 进阶用法
你也可以在 Claude Code 的交互式会话中使用。先启动 Claude Code:
```bash
claude
```
然后在对话中自由提问:
```text
> 用 meowload 查看 https://www.bilibili.com/video/BV1xxxxxxxxx 有哪些资源
> 帮我下载其中的视频和字幕
> 这个链接也帮我下载一下 https://www.douyin.com/video/xxxx
```
Claude Code 会记住上下文,你可以像和助手对话一样连续操作。
## 工作原理
1. 你用自然语言告诉 Claude Code 想要做什么
2. Claude Code 将你的需求翻译为 `meowload` 命令
3. 经你确认后,Claude Code 在终端中执行命令
4. `meowload` 与桌面软件通信,完成资源下载
整个过程不需要任何额外配置——只要 `meowload` 在你的系统 PATH 中可用,Claude Code 就能直接调用它。
> [!TIP]
>
> 你不需要记住 `meowload` 的命令语法和参数。直接用日常语言描述你的需求,Claude Code 会帮你组装正确的命令。如需了解 `meowload` 的完整命令参考,请查看 [CLI 文档](https://docs.henghengmao.com/cli)。
---
# 搭配 Codex CLI 使用
> 通过 OpenAI Codex CLI 调用 meowload 命令行工具,用自然语言提示词下载 YouTube、Instagram、TikTok 等平台的视频和音频,支持全自动模式批量执行。
来源: https://docs.henghengmao.com/cli/use-with-codex
Codex CLI 是 OpenAI 推出的开源终端 AI 编程代理。它可以直接在你的终端中执行 Shell 命令,这意味着你可以用自然语言让 Codex 调用 `meowload` 来下载资源——无需记忆任何命令语法。
## 前提条件
1. 已安装 [MeowLoad 桌面软件](https://www.henghengmao.com/app)(v3.9.9 或更高版本)并已登录账号
2. 已安装 Codex CLI
在终端中运行以下命令,确认两者都已就绪:
```bash
meowload version
codex --version
```
## 关于 Codex 沙箱模式
Codex CLI 默认运行在沙箱环境中,网络访问会被限制。由于 `meowload` 需要与桌面软件通信,建议使用 `Full Auto` 模式以确保命令正常执行:
```bash
codex --full-auto "用 meowload 下载这个视频 https://www.youtube.com/watch?v=dQw4w9WgXcQ"
```
或者在交互式会话中切换到 Full Auto 模式。
## 快速上手
打开终端,直接用自然语言描述你的需求:
```bash
codex "用 meowload 下载这个视频 https://www.youtube.com/watch?v=dQw4w9WgXcQ"
```
Codex 会自动识别你的意图,调用 `meowload download` 命令完成下载。
## 提示词示例
以下是一些你可以直接使用的提示词,复制粘贴到 Codex 中即可:
### 下载视频
```text
用 meowload 下载这个链接里的视频:https://www.youtube.com/watch?v=xxxx
```
### 只下载音频
```text
用 meowload 只下载音频:https://www.youtube.com/watch?v=xxxx
```
### 下载前先查看资源信息
```text
用 meowload 查看这个链接有哪些可下载的资源:https://www.youtube.com/watch?v=xxxx
如果有视频和字幕,帮我都下载下来
```
### 批量下载多个链接
```text
用 meowload 依次下载以下链接的视频:
1. https://www.instagram.com/reel/xxxx
2. https://www.tiktok.com/@user/video/xxxx
3. https://www.youtube.com/watch?v=xxxx
```
### 下载直播流
```text
用 meowload 录制这个直播:https://www.twitch.tv/xxxx
```
## 进阶用法
你也可以在 Codex 的交互式会话中使用。先启动 Codex:
```bash
codex
```
然后在对话中自由提问:
```text
> 用 meowload 查看 https://www.bilibili.com/video/BV1xxxxxxxxx 有哪些资源
> 帮我下载其中的视频和字幕
> 这个链接也帮我下载一下 https://www.douyin.com/video/xxxx
```
Codex 会记住上下文,你可以像和助手对话一样连续操作。
## 工作原理
1. 你用自然语言告诉 Codex 想要做什么
2. Codex 将你的需求翻译为 `meowload` 命令
3. 根据你的审批模式,Codex 自动执行或等待你确认
4. `meowload` 与桌面软件通信,完成资源下载
整个过程不需要任何额外配置(如 MCP 服务器等)——只要 `meowload` 在你的系统 PATH 中可用,Codex 就能直接调用它。
> [!TIP]
>
> 你不需要记住 `meowload` 的命令语法和参数。直接用日常语言描述你的需求,Codex 会帮你组装正确的命令。如需了解 `meowload` 的完整命令参考,请查看 [CLI 文档](https://docs.henghengmao.com/cli)。
---
# 哼哼猫开发者接口文档
> 哼哼猫开发者接口 v1 文档:REST 与 MCP 两种接入方式,覆盖 1000+ 平台的单帖、批量与字幕提取,另有 YouTube 代理下载、音视频转文字与额度查询,附快速开始、错误码与代码示例。
来源: https://docs.henghengmao.com/developer
> [!NOTE]
>
> 本文档是当前版本(v1)接口。仍在使用老版本(无版本号 `/openapi/…`)接口的开发者,文档见 GitHub [Media-Downloader-API](https://github.com/MeowLoad/Media-Downloader-API),迁移指南见 [从老版本迁移](https://docs.henghengmao.com/developer/migration)。
## 🚀 快速开始
哼哼猫开发者接口 v1 提供两种接入方式,用同一个 API Key、同一套计费:
- **REST API**:接口地址统一以 `https://api.meowload.net/openapi/v1` 开头,响应均为 JSON,文件使用签名单次 PUT 上传,鉴权只需在 `Authorization` 请求头里带上 `Bearer <你的 API Key>`
- **MCP**:托管的 MCP server(`https://api.meowload.net/mcp`),配好后可在 Claude Code、Codex、Cursor 等 AI Agent 里直接调用,不需要写代码;音视频转文字仅通过 REST 提供
> [!TIP]
>
> **获取 API Key**
>
> 在开始之前,请先前往 [开发者管理中心](https://www.henghengmao.com/user/developer) 获取您的 API Key。
从 [快速开始](https://docs.henghengmao.com/developer/quickstart) 入手,一次 curl 即可调通;不想写代码,看 [MCP 接入](https://docs.henghengmao.com/developer/mcp)。
## 📚 接口列表
### 核心接口
| 接口 | 功能描述 | API 参考 |
| ---------------------------------------------------- | -------------------------------------- | -------------------------------------------------------------------------- |
| [单帖提取](https://docs.henghengmao.com/developer/media-downloader-api) | 提取单个视频、图片、音乐等媒体内容 | [POST /extract/post](https://docs.henghengmao.com/developer/api-reference#POST/extract/post) |
| [批量提取](https://docs.henghengmao.com/developer/playlist-downloader-api) | 批量提取主页、播放列表、频道、话题内容 | [POST /extract/playlist](https://docs.henghengmao.com/developer/api-reference#POST/extract/playlist) |
| [字幕提取](https://docs.henghengmao.com/developer/video-subtitle-downloader-api) | 提取 YouTube 与 B 站字幕 | [POST /extract/subtitles](https://docs.henghengmao.com/developer/api-reference#POST/extract/subtitles) |
| [YouTube 代理下载](https://docs.henghengmao.com/developer/youtube-proxy-download-api) | 提取 YouTube 媒体信息与临时代理下载链接 | [POST /youtube/proxy-download](https://docs.henghengmao.com/developer/api-reference#POST/youtube/proxy-download) |
| [文件上传](https://docs.henghengmao.com/developer/file-upload-api) | 申请可复用上传 ID 和可选的单次 PUT 地址 | [POST /uploads](https://docs.henghengmao.com/developer/api-reference#POST/uploads) |
| [音视频转文字](https://docs.henghengmao.com/developer/transcription-api) | 引用已上传音频或提交音视频直链,异步获取文字与时间戳 | [POST /transcriptions](https://docs.henghengmao.com/developer/api-reference#POST/transcriptions) |
| [查询额度](https://docs.henghengmao.com/developer/available-credits-api) | 查询账户剩余 API 积分 | [GET /credits](https://docs.henghengmao.com/developer/api-reference#GET/credits) |
提取接口成功(HTTP `200`)才扣费;转录在音频准备后预扣,执行失败退回,查询任务免费。计费规则见 [开发者管理中心](https://www.henghengmao.com/user/developer)。
### 代码示例
Python、JavaScript、PHP、Golang 四种语言的完整调用示例:
- [Python](https://docs.henghengmao.com/developer/code-example/python)
- [JavaScript](https://docs.henghengmao.com/developer/code-example/javascript)
- [PHP](https://docs.henghengmao.com/developer/code-example/php)
- [Golang](https://docs.henghengmao.com/developer/code-example/golang)
## 下一步
- [快速开始](https://docs.henghengmao.com/developer/quickstart):获取 API Key、发出第一个请求、读懂响应与错误体
- [API 参考](https://docs.henghengmao.com/developer/api-reference):全部端点的完整参数与响应字段,可在线调试
- [错误码](https://docs.henghengmao.com/developer/errors):18 个提取错误码与 `retryable` 语义
- [MCP 接入](https://docs.henghengmao.com/developer/mcp):在 Claude Code、Codex、Cursor 里直接调用
- [代码示例](https://docs.henghengmao.com/developer/code-example):Python、JavaScript、PHP、Golang
- [从老版本迁移](https://docs.henghengmao.com/developer/migration):老版本接口到 v1 的字段改名对照与迁移清单
---
# 快速开始
> 用一次 curl 调通哼哼猫开发者 API v1:获取 API Key、发出第一个提取请求、读懂响应与错误体,再了解计费与额度查询。
来源: https://docs.henghengmao.com/developer/quickstart
> [!NOTE]
>
> 本文档是当前版本(v1)接口。仍在使用老版本(无版本号 `/openapi/…`)接口的开发者,文档见 GitHub [Media-Downloader-API](https://github.com/MeowLoad/Media-Downloader-API),迁移指南见 [从老版本迁移](https://docs.henghengmao.com/developer/migration)。
v1 是当前的开发者接口版本。接口地址统一以 `https://api.meowload.net/openapi/v1` 开头,鉴权只需要在 `Authorization` 请求头里带上 `Bearer <你的 API Key>`。完整的端点、参数与响应结构见 [API 参考](https://docs.henghengmao.com/developer/api-reference),本页只带你把第一个请求调通。
## 获取 API Key
前往 [API Key 管理页](https://www.henghengmao.com/user/developer/api-keys),填写名称(可选,留空使用 `default`),点击「创建 API Key」,然后从表格中复制完整 Key。进入页面不会自动创建 Key。请像密码一样妥善保管 API Key,不要写进前端代码或公开仓库。
每个用户最多创建 5 个 Key,可分别用于不同业务,停用的 Key 也占名额。所有 Key 共用用户的 API 积分;每个 Key 的 v1 与 MCP 共用每分钟 1200 次的频控额度,不同 Key 独立计数。
已有 Key 继续可用。需要更换时,先创建新 Key 并切换业务配置,再删除旧 Key。停用可随时恢复,删除不可恢复,使用该 Key 的请求会立即失效;两种操作都不影响余额和其他 Key。
下文所有示例里的 `<你的 API Key>` 都是占位符,需要替换成你自己的 Key。
## 第一个请求
以单个帖子提取为例:
```bash
curl -X POST https://api.meowload.net/openapi/v1/extract/post \
-H "Content-Type: application/json" \
-H "Authorization: Bearer <你的 API Key>" \
-H "Accept-Language: zh" \
-d '{"url": "https://www.youtube.com/watch?v=dQw4w9WgXcQ"}'
```
三个请求头的作用:
| 请求头 | 必填 | 说明 |
| ----------------- | ---- | ---------------------------------------------------------- |
| `Content-Type` | 是 | 固定 `application/json` |
| `Authorization` | 是 | `Bearer <你的 API Key>`,`Bearer` 与 Key 之间有一个空格 |
| `Accept-Language` | 否 | 错误消息语言,默认 `en`,支持 `zh`、`en`、`ja`、`es`、`de` 等 |
## 读响应
成功时 HTTP 状态码为 `200`,响应体直接就是提取结果:
```json
{
"site": "youtube",
"id": "dQw4w9WgXcQ",
"title": "Rick Astley - Never Gonna Give You Up (Official Video)",
"text": "The official video for “Never Gonna Give You Up” by Rick Astley.",
"medias": [
{
"media_type": "video",
"resource_url": "https://rr3---sn-example.googlevideo.com/videoplayback?expire=1757300000&id=o-AbC",
"preview_url": "https://i.ytimg.com/vi/dQw4w9WgXcQ/maxresdefault.jpg",
"duration": 213,
"variants": [
{
"quality": 1080,
"quality_label": "1080p",
"video_url": "https://rr3---sn-example.googlevideo.com/videoplayback?itag=137&expire=1757300000",
"video_ext": "mp4",
"video_filesize": 58203122,
"audio_url": "https://rr3---sn-example.googlevideo.com/videoplayback?itag=140&expire=1757300000",
"audio_ext": "m4a",
"audio_filesize": 3451212,
"is_default": true
},
{
"quality": 720,
"quality_label": "720p",
"video_url": "https://rr3---sn-example.googlevideo.com/videoplayback?itag=22&expire=1757300000",
"video_ext": "mp4",
"video_filesize": 31776500
}
]
}
],
"author": {
"username": "RickAstleyVEVO",
"display_name": "Rick Astley",
"avatar_url": "https://yt3.ggpht.com/example=s176-c-k-c0x00ffffff-no-rj"
},
"stats": {
"view_count": 1600000000,
"like_count": 18000000
},
"created_at": "2009-10-25T06:57:33Z",
"post_url": "https://www.youtube.com/watch?v=dQw4w9WgXcQ"
}
```
读它时记住几件事:
- **`title` 与 `text` 都是可选的。** 有标题的平台(YouTube、B 站、小红书、Reddit 等)两个都可能有;没有标题的平台(推特、Instagram、抖音、TikTok 等)只有 `text`。取展示用文案可以写 `title || text`。
- **没有值的字段整个省略,不会给 `null` 或空串。** 读任何非必填字段都要做缺省处理。
- **`medias[].variants[]` 是同一媒体的多个清晰度或音轨。** `quality` 是高度像素(`9999` 表示原画),`quality_label` 是展示用标注;多档时 `is_default` 为 `true` 的那档是推荐档。一个变体**同时有 `video_url` 和 `audio_url`** 就表示音视频分离,需要各自下载后合并。
- **媒体直链是短效的**,请拿到后尽快下载,不要长期保存或直接嵌进页面
- **带 `headers` 的媒体下载时要原样带上这些请求头**,否则会被平台拒绝
- **`site` 是这条链接所属的平台 id**(如 `youtube`、`tiktok`),无法归类时省略
主页批量提取(`/extract/playlist`)与字幕提取(`/extract/subtitles`)的响应结构见 [API 参考](https://docs.henghengmao.com/developer/api-reference)。
## 处理失败
任何非 `200` 的响应体都是同一种形状:
```json
{
"message": "该内容已被删除或不存在",
"code": "content_deleted",
"retryable": false
}
```
- `message` 是给人看的说明,语言由 `Accept-Language` 决定,**不要拿它做逻辑判断**
- `code` 是机器可读的错误码,`400` 一定带,`429` 固定为 `too_many_requests`
- `retryable` 表示同一个链接稍后重试是否可能成功
按状态码分支:
| 状态码 | 含义 | 怎么处理 |
| ------ | ------------ | --------------------------------------------------------------------- |
| `400` | 提取失败 | 读 `code` 与 `retryable`:`true` 可延迟重试,`false` 是确定性失败,换链接 |
| `401` | API Key 无效 | 检查 `Authorization` 请求头是否为 `Bearer <你的 API Key>` |
| `402` | 额度用尽 | 前往 [开发者管理中心](https://www.henghengmao.com/user/developer) 充值 |
| `422` | 请求体不合法 | 如缺 `url` 或不是 JSON,`detail` 里列出校验问题 |
| `429` | 触发限流 | 每个 Key 每分钟 1200 次,`code` 为 `too_many_requests`,退避后重试 |
| `500` | 服务器错误 | 稍后重试,持续出现请联系我们 |
**提取失败(`400`)不扣费。** 全部 18 个错误码及含义见 [错误码](https://docs.henghengmao.com/developer/errors)。
## 计费与额度
提取接口只有成功(`200`)才扣费,扣多少取决于接口与平台。转录在音频准备后预扣、执行失败退回,查询免费,流程见 [音视频转文字](https://docs.henghengmao.com/developer/transcription-api)。具体规则见 [开发者管理中心](https://www.henghengmao.com/user/developer) 的「计费规则」,查询额度不扣费。
随时可以查询剩余额度:
```bash
curl https://api.meowload.net/openapi/v1/credits \
-H "Authorization: Bearer <你的 API Key>"
```
```json
{ "availableCredits": 282539 }
```
系统会在剩余额度低于 10000、2000、300、100、0 时发送邮件和短信预警,你也可以用这个接口自建监控。
## 下一步
- [API 参考](https://docs.henghengmao.com/developer/api-reference):四个端点的完整定义,可在线调试
- [POST /extract/post](https://docs.henghengmao.com/developer/api-reference#POST/extract/post) 单个帖子
- [POST /extract/playlist](https://docs.henghengmao.com/developer/api-reference#POST/extract/playlist) 主页批量
- [POST /extract/subtitles](https://docs.henghengmao.com/developer/api-reference#POST/extract/subtitles) 字幕
- [GET /credits](https://docs.henghengmao.com/developer/api-reference#GET/credits) 剩余额度
- [从老版本迁移](https://docs.henghengmao.com/developer/migration):老版本接口到 v1 的字段改名对照表
- [错误码](https://docs.henghengmao.com/developer/errors):18 个提取错误码与 `retryable` 语义
- [MCP 接入](https://docs.henghengmao.com/developer/mcp):在 Claude Code、Codex、Cursor 里直接调用
- 代码示例:[Python](https://docs.henghengmao.com/developer/code-example/python)、[JavaScript](https://docs.henghengmao.com/developer/code-example/javascript)、[PHP](https://docs.henghengmao.com/developer/code-example/php)、[Golang](https://docs.henghengmao.com/developer/code-example/golang)
转录的本地音频先通过 [签名单次 PUT 上传](https://docs.henghengmao.com/developer/file-upload-api),再提交取得的 uploadId,不向转录端点发送 multipart 文件正文;媒体直链输入继续保留。
---
# 单个帖子(视频/图集/音乐/直播流)提取接口
> 传一条帖子链接,返回其中视频、图片、音乐、直播流的下载直链,以及标题、文案、封面、作者等元信息,覆盖 1000+ 平台,支持多清晰度与短链接。
来源: https://docs.henghengmao.com/developer/media-downloader-api
传入一条帖子链接,返回其中全部媒体(视频、图片、音频、直播流)的下载直链,以及标题、文案、封面、作者等元信息。覆盖哼哼猫支持的 1000+ 社交与视频平台,如 YouTube、TikTok、Instagram、Facebook、Twitter(X)、小红书、B 站、微博等;`youtu.be`、`vt.tiktok.com` 这类短链接也可以直接传。
## 🎯 基本信息
| 项目 | 内容 |
| ------------ | ----------------------------------------------------------------------------------------------------------------------- |
| **接口地址** | `https://api.meowload.net/openapi/v1/extract/post` |
| **请求方式** | `POST`,请求体为 JSON |
| **鉴权** | 请求头 `Authorization: Bearer <你的 API Key>`,Key 在 [开发者管理中心](https://www.henghengmao.com/user/developer) 获取 |
| **计费** | 仅成功(`200`)时扣 API 积分,规则见 [开发者管理中心](https://www.henghengmao.com/user/developer) |
第一次接入可先看 [快速开始](https://docs.henghengmao.com/developer/quickstart)。
## 📋 请求参数
| 参数 | 类型 | 必填 | 说明 |
| ----- | ------ | ---- | ------------------------ |
| `url` | string | 是 | 帖子链接,短链接可直接传 |
错误消息默认为英文,需要中文时加请求头 `Accept-Language: zh`。
### 请求示例
```bash
curl -X POST https://api.meowload.net/openapi/v1/extract/post \
-H "Content-Type: application/json" \
-H "Authorization: Bearer <你的 API Key>" \
-d '{"url": "https://www.youtube.com/watch?v=dQw4w9WgXcQ"}'
```
## 🟢 成功响应
### 响应示例
HTTP 状态码为 `200`,响应体就是提取结果。下面的示例经过裁剪,只保留最常用的字段:
```json
{
"site": "youtube",
"title": "Scenic tour of the Karst mountains",
"text": "A drone flight over the Karst mountains at sunrise. Filmed in 4K.",
"medias": [
{
"media_type": "video",
"resource_url": "https://video.example.com/v/EXAMPLE0001/360p.mp4?expire=1700000000&sig=EXAMPLE",
"preview_url": "https://images.example.com/EXAMPLE0001/cover.jpg",
"duration": 55,
"headers": { "Referer": "https://www.example.com/" },
"variants": [
{
"quality": 1080,
"quality_label": "1080p",
"video_url": "https://video.example.com/v/EXAMPLE0001/1080p.mp4?expire=1700000000&sig=EXAMPLE",
"video_ext": "mp4",
"video_filesize": 25051752,
"audio_url": "https://video.example.com/v/EXAMPLE0001/audio-en.m4a?expire=1700000000&sig=EXAMPLE",
"audio_ext": "m4a",
"audio_filesize": 887229,
"is_default": true
},
{
"quality": 360,
"quality_label": "360p",
"video_url": "https://video.example.com/v/EXAMPLE0001/360p.mp4?expire=1700000000&sig=EXAMPLE",
"video_ext": "mp4",
"video_filesize": 3742315
}
]
}
],
"id": "EXAMPLE0001",
"post_url": "https://www.youtube.com/watch?v=EXAMPLE0001",
"created_at": "2025-06-02T12:00:00.000Z",
"author": { "username": "@travelchannel", "display_name": "Travel Channel" }
}
```
### 响应字段说明
- `medias[]` 是这条帖子的全部媒体。`media_type` 区分 `video`、`image`、`audio`、`live`、`file`,`resource_url` 是可直接下载的地址。
- 视频有多个清晰度时给出 `variants[]`。`quality` 是高度像素(`9999` 表示原画),`quality_label` 是展示用标注,`is_default` 为 `true` 的那档是推荐档;一个变体同时有 `video_url` 与 `audio_url` 表示音视频分离,需要各自下载后合并。
- 媒体直链是短效的,请拿到后尽快下载。媒体带 `headers` 时,下载请求要原样带上这些请求头,否则会被平台拒绝。
- 没有值的字段整个省略,不会给 `null` 或空串。`title` 与 `text` 都可能缺省,展示用文案可取 `title || text`。
- `created_at` 是可选字符串:准确时刻为 UTC ISO 8601(以 `Z` 结尾,保留毫秒,如 `2026-10-06T13:37:04.123Z`);平台只提供相对时间时返回原文(如 `3 days ago`);两者都没有时省略。只有 ISO 值可用于日期排序、筛选和时区转换,相对文案应原样展示,不按当前时间倒推。
- 同样的规则适用于 `medias[].created_at` 和 `author.created_at`。帖子、媒体、账号的时间分别表示发布时间、媒体创建时间和账号注册时间,各自保留,不互相覆盖。
完整参数与响应字段见 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/post)。
## 🔴 错误响应
提取失败返回 HTTP `400`,不扣 API 积分,响应体带机器可读的 `code` 与 `retryable`(稍后重试同一链接是否可能成功):
```json
{ "message": "该内容已被删除或不存在", "code": "content_deleted", "retryable": false }
```
`401`(API Key 无效)、`402`(API 积分用尽)、`422`(请求体不合法)、`429`(触发限流)与全部提取错误码的处理方式见 [错误码](https://docs.henghengmao.com/developer/errors)。
---
# 主页(播放列表/频道/Hashtag/话题)批量提取接口
> 传一个主页、播放列表、频道或 Hashtag 链接,按页返回其中的帖子与主页资料,拿 next_cursor 游标翻页即可批量采集整个主页。
来源: https://docs.henghengmao.com/developer/playlist-downloader-api
传入一个主页链接——博主或频道主页、播放列表、合集、Hashtag 或话题页——按页返回其中的帖子列表,并附上主页本身的资料(名称、头像、粉丝数等)。每条帖子的结构与 [单个帖子提取接口](https://docs.henghengmao.com/developer/media-downloader-api) 一致,拿返回的 `next_cursor` 逐页翻下去就能取完整个主页。哼哼猫「主页批量提取」支持的平台本接口都支持,如 YouTube(频道页、Shorts、Hashtag、播放列表)、Instagram(作者主页、Hashtag)、Twitter(X)、TikTok(作者主页、Hashtag)、D(主页、合集)、B 站(主页、合集)、微博等。
## 🎯 基本信息
| 项目 | 内容 |
| ------------ | ----------------------------------------------------------------------------------------------------------------------- |
| **接口地址** | `https://api.meowload.net/openapi/v1/extract/playlist` |
| **请求方式** | `POST`,请求体为 JSON |
| **鉴权** | 请求头 `Authorization: Bearer <你的 API Key>`,Key 在 [开发者管理中心](https://www.henghengmao.com/user/developer) 获取 |
| **计费** | 仅成功(`200`)时扣 API 积分,规则见 [开发者管理中心](https://www.henghengmao.com/user/developer) |
第一次接入可先看 [快速开始](https://docs.henghengmao.com/developer/quickstart)。
## 📋 请求参数
| 参数 | 类型 | 必填 | 说明 |
| -------- | ------ | ---- | ---------------------------------------------------------- |
| `url` | string | 是 | 主页链接(频道、播放列表、话题等) |
| `cursor` | string | - | 分页游标,第一页不传,后续页传上一页返回的 `next_cursor` |
错误消息默认为英文,需要中文时加请求头 `Accept-Language: zh`。
### 请求示例
```bash
# 第一页
curl -X POST https://api.meowload.net/openapi/v1/extract/playlist \
-H "Content-Type: application/json" \
-H "Authorization: Bearer <你的 API Key>" \
-d '{"url": "https://www.youtube.com/@Nike/videos"}'
# 第二页:把上一页返回的 next_cursor 作为 cursor 传入
curl -X POST https://api.meowload.net/openapi/v1/extract/playlist \
-H "Content-Type: application/json" \
-H "Authorization: Bearer <你的 API Key>" \
-d '{"url": "https://www.youtube.com/@Nike/videos", "cursor": "4qmFsgKRARIYVUNzQlZQMWpGeU1CQ21Za2xaeXhpVEE0"}'
```
## 🟢 成功响应
### 响应示例
HTTP 状态码为 `200`,响应体是当前这一页的内容。下面的示例经过裁剪,只保留最常用的字段:
```json
{
"site": "youtube",
"posts": [
{
"id": "EXAMPLE0002",
"title": "Top plays of the week",
"post_url": "https://www.youtube.com/watch?v=EXAMPLE0002",
"created_at": "2025-07-20T08:00:00.000Z",
"medias": [
{
"media_type": "video",
"resource_url": "https://video.example.com/v/EXAMPLE0002/720p.mp4?expire=1700000000&sig=EXAMPLE",
"preview_url": "https://images.example.com/EXAMPLE0002/cover.jpg",
"duration": 128
}
]
},
{
"id": "EXAMPLE0003",
"title": "Behind the scenes",
"post_url": "https://www.youtube.com/watch?v=EXAMPLE0003",
"created_at": "2025-07-18T15:30:00.000Z",
"medias": [{ "media_type": "image", "resource_url": "https://images.example.com/EXAMPLE0003/cover.jpg" }]
}
],
"next_cursor": "4qmFsgKRARIYVUNzQlZQMWpGeU1CQ21Za2xaeXhpVEE0",
"has_more": true,
"profile": {
"username": "@techchannel",
"display_name": "Tech Channel",
"avatar_url": "https://images.example.com/channel/avatar.jpg",
"post_count": 342
}
}
```
### 响应字段说明
- `posts[]` 是当前页的帖子,每条与单个帖子接口的响应同构:`medias[]`、`title`、`text`、`author` 等字段都可能出现,视频同样可能带 `variants[]` 与 `headers`。
- `has_more` 为 `true` 时,把 `next_cursor` 原样作为下一次请求的 `cursor` 传入即可取下一页;为 `false` 表示已到末页,此时 `next_cursor` 为空串。游标是不透明字符串,不要解析或拼接。
- `profile` 是这个主页的主体(频道、博主或话题)的资料,`site` 是链接所属的平台。
- `created_at` 是可选字符串:准确时刻为 UTC ISO 8601(以 `Z` 结尾,保留毫秒,如 `2026-10-06T13:37:04.123Z`);平台只提供相对时间时返回原文(如 `3 days ago`);两者都没有时省略。只有 ISO 值可用于日期排序、筛选和时区转换,相对文案应原样展示,不按当前时间倒推。
- 同样的规则适用于 `posts[].created_at`、各帖的媒体与作者,以及 `profile.created_at`。帖子、媒体、账号的时间分别表示发布时间、媒体创建时间和账号注册时间,各自保留,不互相覆盖。
- 媒体直链是短效的,请拿到后尽快下载。媒体带 `headers` 时,下载请求要原样带上这些请求头,否则会被平台拒绝。
完整参数与响应字段见 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/playlist)。
## 🔴 错误响应
提取失败返回 HTTP `400`,不扣 API 积分,响应体带机器可读的 `code` 与 `retryable`(稍后重试同一链接是否可能成功):
```json
{ "message": "该内容已被删除或不存在", "code": "content_deleted", "retryable": false }
```
`401`(API Key 无效)、`402`(API 积分用尽)、`422`(请求体不合法)、`429`(触发限流)与全部提取错误码的处理方式见 [错误码](https://docs.henghengmao.com/developer/errors)。
---
# 字幕提取接口
> 提取 YouTube 与 B 站视频已有的人工或自动字幕。YouTube 提供多格式链接,B 站返回 BCC JSON,可自行转换为 SRT 或 VTT。
来源: https://docs.henghengmao.com/developer/video-subtitle-downloader-api
传入 YouTube 或 B 站视频链接,返回全部可用字幕轨道及视频标题、时长、封面等元信息。YouTube 轨道可提供多种格式。
## 🎯 基本信息
| 项目 | 内容 |
| ------------ | ----------------------------------------------------------------------------------------------------------------------- |
| **接口地址** | `https://api.meowload.net/openapi/v1/extract/subtitles` |
| **请求方式** | `POST`,请求体为 JSON |
| **鉴权** | 请求头 `Authorization: Bearer <你的 API Key>`,Key 在 [开发者管理中心](https://www.henghengmao.com/user/developer) 获取 |
| **计费** | 仅成功(`200`)时扣 API 积分,规则见 [开发者管理中心](https://www.henghengmao.com/user/developer) |
第一次接入可先看 [快速开始](https://docs.henghengmao.com/developer/quickstart)。
## 📋 请求参数
| 参数 | 类型 | 必填 | 说明 |
| ----- | ------ | ---- | -------- |
| `url` | string | 是 | 视频链接 |
错误消息默认为英文,需要中文时加请求头 `Accept-Language: zh`。
### 请求示例
```bash
curl -X POST https://api.meowload.net/openapi/v1/extract/subtitles \
-H "Content-Type: application/json" \
-H "Authorization: Bearer <你的 API Key>" \
-d '{"url": "https://www.youtube.com/watch?v=jNQXAC9IVRw"}'
```
## 🟢 成功响应
### 响应示例
HTTP 状态码为 `200`,响应体是视频元信息加全部字幕轨道。下面的示例经过裁剪:
```json
{
"site": "youtube",
"id": "EXAMPLE0004",
"title": "Me at the zoo",
"duration": 19,
"created_at": "2005-04-24T03:31:52.000Z",
"thumbnail_url": "https://images.example.com/EXAMPLE0004/cover.jpg",
"subtitles": [
{
"language_name": "English",
"language_tag": "en",
"urls": [
{ "url": "https://www.youtube.com/api/timedtext?v=EXAMPLE0004&fmt=srt&sig=EXAMPLE", "format": "srt" },
{ "url": "https://www.youtube.com/api/timedtext?v=EXAMPLE0004&fmt=vtt&sig=EXAMPLE", "format": "vtt" }
]
},
{
"language_name": "English (auto-generated)",
"language_tag": "en",
"urls": [
{ "url": "https://www.youtube.com/api/timedtext?v=EXAMPLE0004&kind=asr&fmt=srt&sig=EXAMPLE", "format": "srt" }
]
}
]
}
```
### 响应字段说明
- `created_at` 是视频的发布时间,准确时间统一返回 UTC ISO 8601(如 `2005-04-24T03:31:52.000Z`);平台仅提供相对时间时保留原文,没有时间时省略。相对时间只用于展示,不要当成准确日期解析。
- `subtitles[]` 每条是一个语言轨道。`language_name` 是语言的本族语显示名(如 English、中文),`language_tag` 是小写 BCP 47 风格的语言标签(如 `en`、`zh-hans`);自动生成的字幕轨也在其中。
- `urls[]` 是该轨道各格式的下载地址:通用播放器选 `srt`,网页播放选 `vtt`,YouTube 程序化处理可选 `json3`。B 站仅提供 `json`(BCC),与 JSON3 不是同一种格式。直链是短效的,请拿到后尽快下载。
- 视频没有字幕时,`subtitles` 为空数组或以 `400` 提取失败返回,两种情况都要处理。
完整参数与响应字段见 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/subtitles)。
## B 站字幕接入
支持 `bilibili.com` 的 BV/av 视频、指定分 P、番剧单集,以及 `b23.tv` 短链;动态、`/opus/` 和国际版 `bilibili.tv` 不在此范围内。多 P 视频的 `id` 相同,应保留完整输入链接中的 `?p=`;番剧结果的 `id` 为 `ep` 开头。
B 站字幕轨道示例(下载地址为示意):
```json
{
"language_tag": "zh",
"language_name": "中文 (auto-generated)",
"urls": [{ "format": "json", "url": "https://aisubtitle.hdslb.com/example.json?auth_key=EXAMPLE" }]
}
```
- 人工和自动字幕可能具有相同的 `language_tag`,不能只按语言标签去重。自动字幕的 `language_name` 带 ` (auto-generated)`,既可能是语音识别,也可能是翻译,接口不再细分。
- 下载链接约 **30 分钟**后失效。
- BCC 的 `body` 是字幕条目数组,每条包含以秒为单位的 `from`、`to` 和文本 `content`。如需 SRT/VTT,请自行转换格式。
## 🔴 错误响应
提取失败返回 HTTP `400`,不扣 API 积分,响应体带机器可读的 `code` 与 `retryable`(稍后重试同一链接是否可能成功):
```json
{ "message": "该内容已被删除或不存在", "code": "content_deleted", "retryable": false }
```
`401`(API Key 无效)、`402`(API 积分用尽)、`422`(请求体不合法)、`429`(触发限流)与全部提取错误码的处理方式见 [错误码](https://docs.henghengmao.com/developer/errors)。
---
# YouTube 代理下载接口
> 传入 YouTube 链接,获取媒体信息与临时代理下载链接,用于服务器直接下载遇到 403 的场景。支持最高 1080p 视频代理、独立音频、Range 续传与 MCP 调用。
来源: https://docs.henghengmao.com/developer/youtube-proxy-download-api
服务器直接下载 YouTube 媒体直链时,可能收到 `403`。这个接口返回与 [单帖提取](https://docs.henghengmao.com/developer/media-downloader-api) 相同的帖子结构,并为符合条件的媒体增加临时代理下载链接。拿到结果后,使用这些链接下载文件。
## 基本信息
| 项目 | 内容 |
| --- | --- |
| 接口地址 | `https://api.meowload.net/openapi/v1/youtube/proxy-download` |
| 请求方式 | `POST`,请求体为 JSON |
| 鉴权 | `Authorization: Bearer <你的 API Key>` |
| 计费 | 仅成功(HTTP `200`)时扣 API 积分,规则见 [开发者管理中心](https://www.henghengmao.com/user/developer) |
| MCP | `youtube_proxy_download`,参数与 REST 相同 |
API Key、余额和充值入口都在开发者管理中心。REST 与 MCP 共用 API Key、额度和限流配额。
## 请求
请求体仅有 `url`,为必填字符串。接受 `youtube.com` 与 `youtu.be` 的 YouTube 链接;不接受其他平台、`youtube-nocookie.com` 嵌入页或指向 YouTube 的第三方短链。频道、播放列表、直播或受限内容是否能提取,以实际结果为准。
```bash
curl --fail-with-body -sS \
https://api.meowload.net/openapi/v1/youtube/proxy-download \
-H "Authorization: Bearer <你的 API Key>" \
-H "Content-Type: application/json" \
--data '{"url":"https://www.youtube.com/watch?v=dQw4w9WgXcQ"}'
```
错误消息默认为英文,需要中文时加 `Accept-Language: zh`。
## 成功响应
HTTP `200` 的响应体直接是帖子对象,保留原有直链与媒体信息。以下为裁剪后的示例,全部下载地址都是占位符:
```json
{
"site": "youtube",
"id": "EXAMPLE0001",
"post_url": "https://www.youtube.com/watch?v=EXAMPLE0001",
"title": "Scenic tour",
"created_at": "2026-10-06T13:37:04.123Z",
"medias": [
{
"media_type": "video",
"duration": 754,
"resource_url": "https://video.example.com/360p.mp4",
"resource_proxy_url": "https://proxy.example/proxy?payload=RESOURCE",
"variants": [
{
"quality": 1080,
"quality_label": "1080p",
"video_url": "https://video.example.com/1080p.mp4",
"video_ext": "mp4",
"video_proxy_url": "https://proxy.example/proxy?payload=VIDEO",
"audio_url": "https://video.example.com/audio.m4a",
"audio_ext": "m4a",
"audio_proxy_url": "https://proxy.example/proxy?payload=AUDIO"
}
]
}
]
}
```
| 字段 | 位置 | 用途 |
| --- | --- | --- |
| `resource_proxy_url` | `medias[]` | 下载媒体本体;视频通常是较低清晰度的完整文件,音频则是音频本体 |
| `video_proxy_url` | `medias[].variants[]` | 下载该档位的视频 |
| `audio_proxy_url` | `medias[].variants[]` | 下载该档位的独立音频,也用于音频媒体的语言音轨 |
准确时间使用 UTC ISO 8601,保留毫秒;相对时间保留平台原文;缺失时间字段省略。完整帖子字段与时间规则见 [单帖提取](https://docs.henghengmao.com/developer/media-downloader-api),完整接口字段见 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/youtube/proxy-download)。
### 代理范围
- 识别出的高清视频代理最高为 `1080p`。更高档位仍可返回直链,但不提供视频代理或配套音频代理;独立音频媒体的语言音轨不受视频清晰度限制。
- 单文件超过 `3 GiB`(`3 × 1024³` 字节)不提供代理链接,恰好等于上限仍允许。缺少大小或清晰度信息时,不会仅因信息缺失排除代理。
- 没有符合条件的代理文件时,仍可能成功返回普通帖子结果,例如 YouTube 社区图文。若本应有代理链接却全部缺失,接口返回 `503 / proxy_unavailable`,不扣 API 积分。
## 下载、合并与续传
选择**带 `video_proxy_url` 的最高可用档位**。只按最高 `quality` 选择,可能选到仅有直链的档位。
原档位同时有 `video_url` 与 `audio_url`,表示音视频分离:分别下载视频和音频,再合并。不能仅凭 `audio_proxy_url` 缺失认定视频已含声音;音频可能未满足代理条件,此时应选择有可用音频代理的档位或音轨。原档位没有独立 `audio_url` 时,可直接下载视频代理。
```bash
ffmpeg -i video.mp4 -i audio.m4a -c copy merged.mp4
```
需要一个现成视频文件时,可使用视频媒体的 `resource_proxy_url`;只要音频时,使用音频媒体的 `resource_proxy_url` 或所需语言档位的 `audio_proxy_url`。
**代理 URL 本身就是下载凭证。** 下载时不加开发者 API Key,也不把 API Key 发送到下载域名。代理支持 `Range`,可在同一有效链接上续传:
```bash
curl --fail-with-body -sS -D range-headers.txt \
-H "Range: bytes=0-1023" \
--output range.bin "<返回的代理 URL>"
```
范围下载应收到 `206` 和正确的 `Content-Range`;续传时把范围起点改为已保存的字节数。流式保存前先检查 HTTP 状态,避免把错误 JSON 保存成媒体文件。错误体请用 GET 检查,HEAD 不返回错误 JSON。
### 有效期与计费边界
代理链接是临时签名链接,最长有效期为一小时,也受 YouTube 文件链接自身到期时间限制。没有保证的最短可用时间,请在收到结果后尽快下载。
接口取得成功结果时计费,下载和有效期内的续传不再扣 API 积分。
开始提取前会检查最低可用额度,返回成功结果前再按实际费用扣 API 积分。实际费用超过余额时返回 `402`,不扣 API 积分,也不交付结果。具体费用和最低额度只在 [开发者管理中心](https://www.henghengmao.com/user/developer) 的「计费规则」维护。
## 错误处理
### 提取接口错误
| HTTP 状态 / 错误码 | 处理 |
| --- | --- |
| `422` | 检查必填的 `url` 与 JSON 请求体 |
| `400 / invalid_url` | `url` 不是有效 URL,修正后再调用 |
| `400 / unsupported_site` | 改用支持的 YouTube 链接 |
| `401` | 检查 API Key 与 Bearer 请求头 |
| `402` | 余额不足,充值后再调用;本次不扣 API 积分、不交付结果 |
| `429` | 达到调用频率限制,稍后再调用 |
| `503 / proxy_unavailable` | 代理暂不可用,`retryable: true`;本次不扣 API 积分,可稍后重试 |
其他提取错误码见 [错误码](https://docs.henghengmao.com/developer/errors)。MCP 通过工具错误结果返回相同的错误码和可重试语义。
### 代理下载错误
这些错误来自下载链接,应与提取接口错误分开处理:
| HTTP 状态 / 错误码 | 处理 |
| --- | --- |
| `404 / payload_expired` | 旧链接已过期,继续重试旧链接无效 |
| YouTube 拒绝请求,例如 `403 / upstream_error` | 查看 `upstream_status`;`retryable: true` 时有限重试或续传 |
| `502 / proxy_failed` | 有限重试同一链接 |
| `403 / content_unavailable` | 内容无法获取,停止反复重试 |
通过 MCP 阅读本页时,可调用 `get_docs`,传入 `page: "youtube-proxy-download-api"`、`lang: "zh"`。
---
# 文件上传 API
> 申请单次 PUT 地址,上传文件原始字节后,将可复用 uploadId 直接交给业务任务,不需要公开 complete 或上传状态查询。
来源: https://docs.henghengmao.com/developer/file-upload-api
`POST https://api.meowload.net/openapi/v1/uploads` 为音频、图片和视频提供同一套上传流程,返回 `uploadId`,需要传文件时还会返回单次 PUT 地址。
申请使用 `Authorization: Bearer <你的 API Key>`。API 积分余额须大于 0,但申请上传不扣积分;业务任务独立检查余额和计费,单价见 [开发者管理中心](https://www.henghengmao.com/user/developer) 的「计费规则」。
## 使用流程
1. 计算原文件的精确字节数和 SHA-256,POST `/uploads` 申请上传。
2. `upload` 非空时,将完整原始文件 PUT 到返回地址,原样携带全部返回请求头,不附加哼哼猫 API Key。等待 PUT 返回成功的 2xx。
3. `upload` 为 null 时,表示已命中本用户可复用的已验证内容,跳过 PUT。
4. 将 `uploadId` 直接交给支持的业务任务。[音视频转文字](https://docs.henghengmao.com/developer/transcription-api) 使用 `mediaType: "audio"` 申请,随后 POST `/transcriptions`,提交 `{uploadId, language?, speakerLabels?}`。
不提供公开 complete、上传状态 GET、分片、地址续签、文件列表或删除端点。服务端在任务后台确认上传并校验文件,验证失败通过该业务任务交付。
音频、图片、视频共用申请接口,但业务仍会核对实际媒体类型。当前转录只接收音频 uploadId,本指南不表示图片/视频任务 API 已经开放。
## 大小与格式
| `mediaType` | 接收范围 |
| --- | --- |
| `audio` | 可解码音频,最多 **1 GiB(1,073,741,824 字节)** |
| `image` | JPEG、PNG、WebP,最多 **30 MiB(31,457,280 字节)**、**1 亿像素** |
| `video` | MP4,最多 **500 MiB(524,288,000 字节)**、**600 秒** |
声明、文件名和 Content-Type 不决定真实格式,仍会验证文件内容、大小、摘要与元数据。文件验证通过,也不代表任意业务或模型都能接收。
M4A/MP4 容器可只包含音频;音频的附带封面不视为真实视频轨道。含真实视频轨的文件不能通过声明 audio 来转录,应先提取音轨再上传,或使用转录的音视频文件直链输入。
## 申请上传
```bash
curl https://api.meowload.net/openapi/v1/uploads \
-H 'Authorization: Bearer <你的 API Key>' \
-H 'Content-Type: application/json' \
-d '{"mediaType":"audio","fileName":"meeting.mp3","sizeBytes":12345678,"sha256":"9f86d081884c7d659a2feaa0c55ad015a3bf4f1b2b0b822cd15d6c15b0f00a08"}'
```
示例大小和摘要仅用于说明,需按实际文件计算。
| 字段 | 必填 | 规则 |
| --- | --- | --- |
| `mediaType` | 是 | `audio`、`image` 或 `video` |
| `fileName` | 否 | 展示用文件名,不作为格式校验依据 |
| `sizeBytes` | 是 | 原文件精确字节数,正整数,须符合所选类型的限制 |
| `sha256` | 是 | 完整原文件的 SHA-256,64 位十六进制字符 |
申请 JSON 正文最多 8 KiB,不包含文件正文,也不接受存储路径、模型、价格、内部素材 ID 或调用方指定的请求 ID。上传申请没有公开幂等参数。
## 响应与 PUT
HTTP `200`:
```json
{
"uploadId": "0123456789abcdefghijklmn",
"upload": {
"method": "PUT",
"url": "https://uploads.example.com/signed-object?signature=EXAMPLE",
"headers": {"Content-Type":"application/octet-stream"},
"expiresAt": "2030-01-01T01:00:00.000Z"
}
}
```
使用完整返回地址和**全部**返回请求头,包括可能存在的校验头。上面的 headers 是示例,不是固定请求头清单。发送文件原始字节,不使用 multipart 表单:
```bash
curl --request PUT '' \
--header 'Content-Type: application/octet-stream' \
--header '<其他返回请求头>: <原值>' \
--data-binary @meeting.mp3
```
PUT 地址最长有效 **1 小时**,同时受当前上传会话剩余时间约束。`upload.expiresAt` 是本次签名地址的期限,不是已验证文件的可用期限。中断后在地址有效期内重传同一个完整文件,不支持分片续传;地址过期则重新申请,不往原地址发送不同内容。
PUT 成功只表示文件送达,不表示通过真实媒体验证。收到 2xx 后直接创建业务任务,不需要解析 ETag、调用 complete 或轮询上传状态。
已验证内容复用响应:
```json
{"uploadId":"0123456789abcdefghijklmn","upload":null}
```
只有明确的 null 才表示可跳过 PUT,并不表示业务任务已经完成。
## 多任务复用与期限
同一有效 uploadId 可以创建多个参数不同的任务,前提是属于本用户、源文件当前可用且符合对应业务的媒体规则。同用户轮换 Key 后仍可引用,他人的 Key 不可使用。
**每次业务 POST 创建独立任务,可能分别收费**,即使引用同一 uploadId。文件身份不是任务幂等键;创建回包丢失时不要自动重试任务 POST。拿到任务 ID 后保存它,只重试免费的结果 GET。
不额外设置“uploadId 创建满 24 小时便禁止新任务”的规则。原上传会话与来源当前使用资格仍然有效,uploadId 不保证永久保存;源文件不再可用时可重新申请上传。已经保存的转录文字不依赖原文件保留,仍可查询。
## Node.js:流式计算摘要并上传
Node.js 24 可使用文件支持的 Blob,示例不会把 1 GiB 文件整体放进内存。摘要计算至 PUT 期间不要修改文件。示例仅创建一次转录,后续按 [转录指南](https://docs.henghengmao.com/developer/transcription-api) 每 3 秒查询。
```javascript
import { createHash } from "node:crypto"
import { createReadStream, openAsBlob } from "node:fs"
const base = "https://api.meowload.net/openapi/v1"
const auth = { Authorization: "Bearer <你的 API Key>", "Content-Type": "application/json" }
const path = "./meeting.mp3"
const file = await openAsBlob(path)
const hash = createHash("sha256")
for await (const chunk of createReadStream(path)) hash.update(chunk)
const application = await fetch(`${base}/uploads`, {
method: "POST",
headers: auth,
body: JSON.stringify({ mediaType: "audio", fileName: "meeting.mp3", sizeBytes: file.size, sha256: hash.digest("hex") }),
})
if (!application.ok) throw new Error(`Upload request failed: ${application.status}`)
const { uploadId, upload } = await application.json()
if (upload !== null) {
const put = await fetch(upload.url, { method: upload.method, headers: upload.headers, body: file })
if (!put.ok) throw new Error(`PUT failed: ${put.status}`)
}
const created = await fetch(`${base}/transcriptions`, {
method: "POST", headers: auth,
body: JSON.stringify({ uploadId, language: "auto", speakerLabels: false }),
})
if (!created.ok) throw new Error(`Create failed: ${created.status}`)
console.log("Save this task ID:", (await created.json()).id)
```
API 请求错误沿用非 2xx 与 `{message, code?, detail?}`。文件真实校验失败通过业务任务返回,发生在执行预扣之前。完整参数与返回字段见 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/uploads)。
---
# 音视频转文字 API
> 通过现有 API Key 引用已上传音频或提交音视频直链,可选识别说话人,免费轮询获取全文与时间戳分段。
来源: https://docs.henghengmao.com/developer/transcription-api
引用已上传的**音频**,或提交音视频文件直链,创建异步转录任务。默认自动识别语言,也可指定语言代码;开启 `speakerLabels` 后识别说话人,人数由模型自动判断。
本能力仅通过 REST 提供,不提供 MCP 工具或开发者回调。使用现有 API Key 和 API 积分,与网站、桌面端的 AI 积分分开。单价见 [开发者管理中心](https://www.henghengmao.com/user/developer) 的「计费规则」。
## 接口与流程
| 接口 | 用途 |
| --- | --- |
| `POST /openapi/v1/uploads` | 申请可复用上传 ID 和可选的单次 PUT 地址 |
| `POST /openapi/v1/transcriptions` | 提交已上传音频 ID 或媒体直链,返回任务 ID |
| `GET /openapi/v1/transcriptions/{id}` | 免费查询任务状态与结果 |
接口地址以 `https://api.meowload.net` 开头,鉴权为 `Authorization: Bearer <你的 API Key>`。只有 API 请求携带该 Key,存储 PUT 只使用返回的上传请求头。
1. 本地音频先按 [文件上传指南](https://docs.henghengmao.com/developer/file-upload-api) 声明 `mediaType: "audio"` 申请上传,完成单次 PUT 后提交 uploadId;只有响应明确返回 `upload: null` 时才跳过 PUT。媒体直链无需申请上传。
2. 用下方任一 JSON 输入 POST `/transcriptions`。HTTP `200` 和任务 ID 表示已持久受理,文件确认、校验和音轨准备在后台继续,之后才预扣并执行。
3. 保存 ID,每 **3 秒** GET 查询一次,到 `completed` 或 `failed` 时停止。失败任务的查询仍返回 HTTP `200`,原因见 `error`;停止轮询不会取消任务。
> [!WARNING]
>
> 每次任务 POST 创建独立任务并分别计费,包括重复引用同一 uploadId 或直链。首版不提供公开 `requestId` 或 `Idempotency-Key`。**不要自动重试 POST**:回包丢失时服务端可能已经受理,再提交可能重复任务与收费。拿到任务 ID 后保存它,只重试免费的 GET。
## 输入参数
两种来源均使用 `Content-Type: application/json`,正文最多 64 KiB,必须二选一。此接口不接收 multipart 文件正文。
| 字段 | 规则 |
| --- | --- |
| `uploadId` | 上传音频时必填,来自 `/uploads`、属于本用户的 24 位 ID;不与 `fileUrl` 或 `fileHeaders` 同传 |
| `fileUrl` | 直链输入必填,HTTP(S) 音视频文件地址,最多 4096 字符 |
| `fileHeaders` | 仅直链输入可选,最多 32 个头,每个值最多 8192 个 UTF-8 字节,名称和值合计最多 16384 字节 |
| `language` | 可选,默认 `auto`;支持 `zh`、`en` 等语言代码,不区分大小写 |
| `speakerLabels` | 可选布尔值,默认 `false`;不接受指定说话人数 |
两种来源的原文件和准备后音频均最多 **1 GiB(1,073,741,824 字节)**。大小通过不代表任意时长的音频都保证处理成功。
uploadId 输入必须是真实音频:纯音频的 M4A/MP4 容器或附带封面的音频可按音频处理;有真实视频轨道则不接受。本地视频应先提取音轨再上传,或自行提供音视频文件直链。不能用通用视频 uploadId 转录。
直链输入支持音频和带有效音轨的视频。不支持网页、直播流和播放列表,网页需先用 [单帖提取](https://docs.henghengmao.com/developer/media-downloader-api) 获得媒体直链;有独立音频时优先使用,并保持地址在后台下载期间有效。
来源请求头仅用于下载文件。拒绝受限请求头,跨源跳转时移除认证信息;不要传入哼哼猫 API Key 或内部凭据。语言全名、`en-US` 等地区码、未知语言码或未知字段返回 `422`,完整代码列表见 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/transcriptions)。
不接受自报时长、价格、模型、说话人数或内部素材 ID。计费使用验证后的真实音频时长,不提供模型选择。
### 提交已上传音频
按 [文件上传指南](https://docs.henghengmao.com/developer/file-upload-api) 完成单次 PUT 后:
```bash
curl https://api.meowload.net/openapi/v1/transcriptions \
-H 'Authorization: Bearer <你的 API Key>' \
-H 'Content-Type: application/json' \
-d '{"uploadId":"0123456789abcdefghijklmn","language":"auto","speakerLabels":false}'
```
不需要公开 complete 或上传状态查询,由任务在后台确认、验证文件。同一有效 uploadId 可以创建多个独立任务,仍须满足当前归属和源文件可用性;不额外设置固定 24 小时业务禁用期限,也不承诺永久保存。
### 提交媒体直链
```bash
curl https://api.meowload.net/openapi/v1/transcriptions \
-H 'Authorization: Bearer <你的 API Key>' \
-H 'Content-Type: application/json' \
-d '{"fileUrl":"https://media.example.com/meeting.mp4","language":"auto","speakerLabels":false}'
```
源文件需要请求头时,在 JSON 中附加 `"fileHeaders":{"Referer":"https://example.com/"}`。
### 受理响应
```json
{"id":"0123456789abcdefghijklmn","status":"processing"}
```
任务 ID 是 24 位不透明字符串,后续查询时原样使用。
## 查询与结果
```bash
curl https://api.meowload.net/openapi/v1/transcriptions/0123456789abcdefghijklmn \
-H 'Authorization: Bearer <你的 API Key>' \
-H 'Accept-Language: zh'
```
开启说话人识别的完成示例:
```json
{
"id": "0123456789abcdefghijklmn",
"status": "completed",
"duration": 15.2,
"language": "zh",
"apiCreditsCost": 3,
"billingStatus": "settled",
"result": {
"text": "大家好,今天开始讨论。",
"segments": [
{"id": 0, "start": 0, "end": 3.2, "speaker": "speaker_0", "text": "大家好,今天开始讨论。"}
]
},
"error": null
}
```
| 字段 | 含义 |
| --- | --- |
| `status` | `processing`、`completed`、`failed` |
| `duration` | 验证后的音频秒数,准备完成前为 null |
| `language` | 完成时识别出的语言,此前为 null |
| `apiCreditsCost` | 本次整数报价,尚未知晓时为 null;退款后仍保留原预扣数值 |
| `billingStatus` | `not_charged` 未扣费、`reserved` 已预扣、`settled` 成功结算、`refunded` 已退回原预扣 |
| `result` | 完成前为 null;完成后为原始全文和分段,不返回源音频地址 |
| `result.segments` | 时间单位为秒,start/end 无有效值时可为 null;关闭说话人识别时不保证 speaker |
| `error` | 非失败状态为 null;失败时为 `{ "message": "…", "code": "snake_case" }` |
没有识别到语音的合法音频可以成功返回空文字,`segments` 为 null 或空数组,仍按音频时长计费。可按分段自行生成 SRT/VTT,本接口不额外提供字幕下载端点。
同一用户的不同 Key 可查询自己的任务,轮换 Key 不影响查询;余额为 0 也可查询。别人的任务及不存在的 ID 均返回 `404`,Web/桌面端任务不会出现在此接口。首版不新增固定的任务正文到期日,也不承诺永久保存;请自行保存所需结果。
## 费用和错误
按验证后的真实音频时长向上取整到整分钟,在执行前预扣 API 积分。准备失败不扣费;准备后余额不足,任务以 `failed` 和 `insufficient_api_credits` 结束,充值后需重新提交;不会等待充值后自动执行。预扣后执行明确失败,退还原预扣。网络超时或受理结果暂不明确时保持 `processing`,不会据此直接退款。
异步失败示例,HTTP `200`:
```json
{
"id": "0123456789abcdefghijklmn",
"status": "failed",
"duration": null,
"language": null,
"apiCreditsCost": null,
"billingStatus": "not_charged",
"result": null,
"error": {"message":"视频没有音轨","code":"audio_track_missing"}
}
```
`audio_track_missing` 表示视频无音轨;`file_too_large` 表示超限;源下载失败、准备超时或转录失败也会返回明确原因码。按 `error.code` 分支,不解析消息文字。
请求本身出错使用非 `200` 和 `{message, code?, detail?}`:`401` 无效 Key、`402` API 积分不足、`422` 参数错误、`429` 每 Key 频控、`503` 尚未受理时服务不可用。具体以 [API 参考](https://docs.henghengmao.com/developer/api-reference#POST/transcriptions) 为准,提取接口的 `retryable` 不适用于转录任务。
## JavaScript:提交一次并轮询
Node.js 18 及以上可直接使用 fetch。示例只发送一次 POST,拿到 ID 后打印并定期免费查询;网络异常时先保留已有 ID,再自行恢复 GET。
```javascript
const base = "https://api.meowload.net/openapi/v1"
const headers = { Authorization: "Bearer <你的 API Key>" }
const response = await fetch(`${base}/transcriptions`, {
method: "POST",
headers: { ...headers, "Content-Type": "application/json" },
body: JSON.stringify({ fileUrl: "https://media.example.com/meeting.mp3" }),
})
if (!response.ok) throw new Error(`Create failed: ${response.status} ${await response.text()}`)
const { id } = await response.json()
console.log("Save this task ID:", id)
for (;;) {
await new Promise(resolve => setTimeout(resolve, 3000))
const query = await fetch(`${base}/transcriptions/${id}`, { headers })
if (!query.ok) throw new Error(`Query failed: ${query.status} ${await query.text()}`)
const task = await query.json()
if (task.status === "processing") continue
if (task.status === "failed") throw new Error(`${task.error.code}: ${task.error.message}`)
console.log(task.result.text)
break
}
```
---
# 查询剩余 API 积分接口
> 查询当前 API Key 所属账户的剩余 API 积分,查询本身免费,可用来做用量监控与自定义余量预警;余额偏低时系统也会发邮件与短信。
来源: https://docs.henghengmao.com/developer/available-credits-api
查询当前 API Key 所属账户的剩余 API 积分。同一用户的所有 Key 共用余额,使用任意有效 Key 查询得到的都是同一笔余额。查询本身不扣 API 积分,可以用来做用量监控与自定义余量预警;系统默认也会在剩余 API 积分低于 10000、2000、300、100 与归零时发送邮件和短信预警。
## 🎯 基本信息
| 项目 | 内容 |
| ------------ | ----------------------------------------------------------------------------------------------------------------------- |
| **接口地址** | `https://api.meowload.net/openapi/v1/credits` |
| **请求方式** | `GET` |
| **鉴权** | 请求头 `Authorization: Bearer <你的 API Key>`,Key 在 [开发者管理中心](https://www.henghengmao.com/user/developer) 获取 |
| **计费** | 免费,不扣 API 积分 |
第一次接入可先看 [快速开始](https://docs.henghengmao.com/developer/quickstart)。
## 📋 请求参数
没有请求体。错误消息默认为英文,需要中文时加请求头 `Accept-Language: zh`。
### 请求示例
```bash
curl https://api.meowload.net/openapi/v1/credits \
-H "Authorization: Bearer <你的 API Key>"
```
## 🟢 成功响应
### 响应示例
HTTP 状态码为 `200`:
```json
{ "availableCredits": 282539 }
```
### 响应字段说明
- `availableCredits` 是剩余 API 积分,整数。提取接口每次成功调用后即时扣减,扣多少取决于接口与平台,规则见 [开发者管理中心](https://www.henghengmao.com/user/developer)。
- 做用量监控时按分钟级轮询即可,不必在每次提取前都查一次。
- API 积分是独立的 API 计费余额,各接口按计费规则消耗积分,不等同于成功调用次数,也不与网站及桌面端的会员、AI 积分共用。
完整定义见 [API 参考](https://docs.henghengmao.com/developer/api-reference#GET/credits)。
## 🔴 错误响应
`401`(API Key 无效)与 `429`(触发限流)的响应体形状与处理方式见 [错误码](https://docs.henghengmao.com/developer/errors)。
## 💳 充值和管理
前往 [开发者管理中心](https://www.henghengmao.com/user/developer) 可以充值 API 积分、查看余量与计费规则、创建及管理最多 5 个 API Key,以及设置余量预警短信的接收手机号。更换 Key 时先创建新 Key,完成业务切换后再删除旧 Key。
系统会在剩余 API 积分到达以下节点时自动发送邮件和短信预警:
- 低于 10000
- 低于 2000
- 低于 300
- 低于 100
- 归零
---
# 错误码
> 哼哼猫开发者 API v1 的统一错误响应:HTTP 状态码含义、18 个提取错误码的成因与处理办法,以及 retryable 字段该怎么用。
来源: https://docs.henghengmao.com/developer/errors
## 错误格式
所有非 `200` 的响应体都是同一种 JSON 结构:
```json
{
"message": "该内容已被删除或不存在",
"code": "content_deleted",
"retryable": false
}
```
| 字段 | 说明 |
| ----------- | ---------------------------------------------------------------------------------------- |
| `message` | 给人看的说明,语言由 `Accept-Language` 请求头决定。**不要拿它做逻辑判断**,措辞会调整。 |
| `code` | 机器可读的错误码。提取失败的 `400` 一定带,`429` 固定为 `too_many_requests`;`401`、`402`、`422`、`500` 不带,用状态码本身判别。请求体不是合法 JSON 时只有 `message`。 |
| `retryable` | 同一链接稍后重试是否可能成功,随 `code` 一起出现 |
| `detail` | 仅 `422` 有,是请求体校验问题的列表 |
## HTTP 状态码
| 状态码 | 含义 | 常见原因 | 处理 |
| ------ | ------------ | ----------------------------------------- | ---------------------------------------------------------------------------- |
| `200` | 成功 | - | 响应体即提取结果,此时才扣费 |
| `400` | 提取失败 | 链接无效、内容不可访问、平台限制等;请求体不是合法 JSON 也是 `400`,但只带 `message` | 按 `code` 处理,见下表。**不扣费。** |
| `401` | 鉴权失败 | 缺 `Authorization` 请求头或不是 `Bearer` 方案、API Key 错误或已重置 | 到 [开发者管理中心](https://www.henghengmao.com/user/developer) 核对 Key |
| `402` | 额度用尽 | API 积分不足以支付本次提取 | 到 [开发者管理中心](https://www.henghengmao.com/user/developer) 充值 |
| `422` | 请求体不合法 | 缺 `url`、`url` 不是字符串、`Content-Type` 不是 JSON(此时请求体按空对象校验) | 看 `detail`,修正请求 |
| `429` | 触发限流 | 超过每个 Key 每分钟 1200 次,`code` 为 `too_many_requests` | 退避后重试。MCP 与 REST 共用这份配额。 |
| `500` | 服务器错误 | 服务内部异常 | 稍后重试,持续出现请联系我们 |
## 提取错误码
提取失败返回 HTTP `400`,`code` 取自下面 18 个值之一。这些都是业务失败,**不扣费**。
| code | 含义 | 常见原因 | 怎么办 | `retryable` |
| --------------------------- | -------------------------------- | ------------------------------------------ | -------------------------------------------- | ----------- |
| `invalid_url` | 链接格式不对 | 传的不是 URL,或没有可识别的链接 | 修正 URL | `false` |
| `unsupported_url` | 不是帖子 / 视频链接 | URL 合法但不是内容页,如站点首页、搜索页 | 换用单个帖子或视频的分享链接 | `false` |
| `unsupported_site` | 该站点暂不支持 | 平台不在支持列表 | 联系我们提需求 | `false` |
| `invalid_playlist_url` | 不是主页 / 频道 / 播放列表链接 | 主页批量接口收到了单帖链接或非列表页 | 换用公开的作者主页、频道或播放列表 URL | `false` |
| `playlist_not_supported` | 把列表链接传给了单帖接口 | `/extract/post` 收到了主页 / 播放列表链接 | 改调 `/extract/playlist`,或传单个帖子链接 | `false` |
| `content_deleted` | 内容已删除或不存在 | 帖子被删、链接错误、从未存在 | 无内容可提取 | `false` |
| `user_not_found` | 找不到该用户 | 账号已注销、改名或被平台限制 | 核对用户名 | `false` |
| `no_story` | 该账号当前没有可看的快拍 | 快拍 24 小时后消失 | 稍后有新快拍时再试 | `false` |
| `private_content` | 私密内容 | 私密账号或仅关注者可见 | 无法提取 | `false` |
| `members_only_content` | 付费或会员专享内容 | 需要订阅、付费或会员身份 | 无法提取 | `false` |
| `age_restricted` | 年龄限制 | 平台要求登录验证年龄 | 无法提取(见下方说明) | `false` |
| `region_restricted` | 地区限制 | 内容仅特定地区可见 | 无法提取(见下方说明) | `false` |
| `not_premiered` | 内容尚未发布 | 预约首映 / 定时发布尚未到时间 | 到点后再试 | `false` |
| `live_stream_not_supported` | 该站点的直播暂不支持 | 直播进行中 | 等直播转为回放后再试(见下方说明) | `false` |
| `extract_failed` | 提取失败 | 站点改版,或该内容当前无法正常访问 | 稍后重试 | `true` |
| `retryable` | 临时失败 | 提取过程中的瞬时错误 | 稍等片刻后重试 | `true` |
| `timeout` | 提取超时 | 本次提取耗时超出限制 | 稍等片刻后重试 | `true` |
| `unknown` | 未归类的失败 | 未预期的错误 | 先重试一次,反复出现请带上请求时间联系我们 | `true` |
> [!NOTE]
>
> `age_restricted`、`region_restricted`、`live_stream_not_supported` 这三个码**只在少数平台上出现**。年龄限制、地区限制的资源我们大多能正常提取,直播也支持很多平台(如 Twitch、TikTok)。收到这三个码只说明**这个平台**的这类资源当前拿不到,不代表不支持这类资源。
## retryable 的语义
`retryable` 是对「同一个链接稍后重试有没有意义」的回答,和错误码一起下发:
- **`true`**:临时性失败,同一链接过一会儿重试有可能成功。建议指数退避,从几秒开始,重试两三次仍失败就放弃并记录。
- **`false`**:关于内容本身的确定性结论(已删除、私密、不支持……),重试多少次结果都一样,不要重试
- **没有这个字段**:按 `false` 处理
错误码会随时间新增。遇到不在上表里的 `code`,按永久失败处理并记录日志,不要循环重试。同一个平台持续返回 `extract_failed`、或 `unknown` 反复出现,请带上请求时间联系我们。
`retryable` 表示的是「可以重试」,不是「一定会成功」;表格里的值是各错误码的典型值,请以响应里实际下发的为准。
---
# MCP 接入
> 把哼哼猫接口接入 Claude Code、Codex、Cursor 等 AI Agent:MCP server 端点、各客户端配置、六个可用工具与计费,以及连不上时怎么排查。
来源: https://docs.henghengmao.com/developer/mcp
哼哼猫提供托管的 **MCP server**(Model Context Protocol,Streamable HTTP)。配好之后,你在 Claude Code、Codex、Cursor 里直接说「帮我提取这个链接里的视频和图片」,AI 就会调用哼哼猫接口,**不需要写代码**。与 REST API 共用用户的 API 积分与计费规则;使用同一个 Key 时,两种入口共用频控额度。
**端点**:`https://api.meowload.net/mcp`
**鉴权**:`Authorization: Bearer <你的 API Key>`,可复用 REST 接口的 Key,也可单独创建。
## 开始之前
先到 [开发者管理中心](https://www.henghengmao.com/user/developer) 创建并复制 API Key。可以为 MCP 单独创建一个 Key,最多 5 个 Key 共用用户的 API 积分,每个 Key 的频控独立。
下面所有配置里的 `<你的 API Key>` **都是占位符,必须换成你自己的真实 Key**。原样粘贴在配置时不会报错,但客户端一连接就会收到 `401`,工具列表里不会出现哼哼猫的工具。
## Claude Code
```bash
claude mcp add --transport http meowload https://api.meowload.net/mcp --header "Authorization: Bearer <你的 API Key>"
```
默认只在**执行命令的那个目录**生效。想让所有项目都能用,加 `-s user`。
## Codex
```text
# ~/.codex/config.toml
[mcp_servers.meowload]
url = "https://api.meowload.net/mcp"
bearer_token_env_var = "MEOWLOAD_API_KEY"
```
`bearer_token_env_var` 填的是**环境变量名**:Codex 启动时读取 `MEOWLOAD_API_KEY` 的值,自动以 `Authorization: Bearer <值>` 的形式发送。先在 shell 里设置这个变量(如 `export MEOWLOAD_API_KEY=<你的 API Key>`),Key 就不用写进配置文件。
不想用环境变量,也可以把请求头直接写进配置:
```text
# ~/.codex/config.toml
[mcp_servers.meowload]
url = "https://api.meowload.net/mcp"
http_headers = { "Authorization" = "Bearer <你的 API Key>" }
```
`~` 指你的用户主目录,文件不存在就自己新建。改完需要**重启 Codex**。
## 通用 JSON 配置(Cursor 等)
Cursor 写进 `~/.cursor/mcp.json`(全局生效)或项目根目录的 `.cursor/mcp.json`(仅该项目)。其他客户端参考各自文档里 MCP 配置文件的位置。
```json
{
"mcpServers": {
"meowload": {
"url": "https://api.meowload.net/mcp",
"headers": { "Authorization": "Bearer <你的 API Key>" }
}
}
}
```
改完需要**重启客户端**。
## 确认连上了
Claude Code 在终端执行:
```bash
claude mcp list
```
看到 `meowload` 且状态为已连接即成功,也可以在会话里输入 `/mcp` 查看。其他客户端一般在设置的 MCP 面板里能看到这个 server——**列出下面 6 个工具就说明通了**。
## 可用工具
| 工具 | 作用 |
| ------------------- | ------------------------------------------ |
| `extract_post` | 提取单个帖子的媒体直链与元数据 |
| `extract_playlist` | 提取主页 / 频道 / 播放列表的一页,支持翻页 |
| `extract_subtitles` | 提取 YouTube 与 B 站字幕 |
| `youtube_proxy_download` | 提取 YouTube 媒体信息与临时代理下载链接 |
| `get_credits` | 查询剩余额度 |
| `get_docs` | 在 Agent 内直接读本站开发者文档 |
提取工具与各自的 REST 接口同价、只在成功时扣 API 积分,`get_credits` 与 `get_docs` 免费。
提取工具返回的响应与 [API 参考](https://docs.henghengmao.com/developer/api-reference) 里对应端点完全一致,字段说明也在那里。
**提取工具返回媒体信息和下载链接。** 要存到本地,让你的 Agent 拿到链接后再下载。链接是短效的,拿到后尽快下载。
`youtube_proxy_download` 只接受 YouTube 链接,请求参数为 `url`。服务器直接下载 YouTube 直链遇到 `403` 时,可使用它返回的代理链接。选档、音视频合并、续传和下载错误处理见 [YouTube 代理下载](https://docs.henghengmao.com/developer/youtube-proxy-download-api)。
`extract_playlist` 一次只取一页:结果里 `has_more` 为 `true` 时,把 `next_cursor` 作为 `cursor` 参数再调一次取下一页。
`get_docs` 的 `page` 参数可选 `quickstart`、`migration`、`errors`、`mcp`、`youtube-proxy-download-api`,`lang` 可选 `zh`、`en`,让 Agent 自己查字段含义和错误码。
## 额度
余额、充值与预警设置都在 [开发者管理中心](https://www.henghengmao.com/user/developer)。额度用尽时提取工具会返回 `Insufficient credits` 与充值地址。计费规则也在那里的「计费规则」。
## 连不上怎么办
| 现象 | 多半是 |
| -------------------------- | -------------------------------------------------------------------------- |
| 连接失败或返回 `401` | `<你的 API Key>` 没换成真实 Key,或漏了 `Bearer` 前缀(`Bearer` 与 Key 之间有一个空格) |
| 配置改了但工具没出现 | 没重启客户端 |
| 返回 `429` | 触发限流。MCP 与 REST API **共用**每个 Key 每分钟 1200 次的配额。 |
| 工具返回错误码 | 与 REST 相同的 `code` 与 `retryable`,含义见 [错误码](https://docs.henghengmao.com/developer/errors) |
## 下一步
- [快速开始](https://docs.henghengmao.com/developer/quickstart):用 REST 方式调用同一套接口
- [API 参考](https://docs.henghengmao.com/developer/api-reference):完整端点文档,可在线调试
- [错误码](https://docs.henghengmao.com/developer/errors):工具返回的错误码含义
试试对你的 Agent 说:「提取这个 YouTube 视频的 1080p 直链和中文字幕:https://...」
---
# Python 代码示例
> Python 调用哼哼猫提取接口的完整示例:requests 同步请求、aiohttp 并发批量提取,并演示怎么读 code 与 retryable 决定是否重试。
来源: https://docs.henghengmao.com/developer/code-example/python
Python 调这套接口只需要一个 HTTP 客户端,标准库的 `urllib.request` 也能跑,但下面两段用的是更顺手的 `requests`(同步)和 `aiohttp`(异步),先 `pip install requests aiohttp`。
本页给两个例子:一次提取一条链接的同步写法,和一次跑一批链接的并发写法。两段都用 `Authorization: Bearer <你的 API Key>` 请求头鉴权,`Bearer` 与 Key 之间有一个空格;把占位符换成[开发者管理中心](https://www.henghengmao.com/user/developer)里的真实 Key 再跑。
## 🚀 使用 requests
最常见的用法:脚本或定时任务里逐条提取,同步等结果回来。两个地方容易踩——`requests` 默认不设超时,目标平台卡住时线程会一直挂着,生产代码要显式传 `timeout=`(一次提取偶尔要十几秒,别设太小);另一处是拿到响应先看 `status_code`,非 200 时响应体是 `{message, code?, retryable?}` 这套形状(只有 `message` 一定有,`code` 与 `retryable` 是提取失败的 400 才带的),直接按成功结构去取 `medias` 会 KeyError。
成功响应里 `title` 与 `text` 都是可选字段,有标题的平台(YouTube、B 站等)两个都可能有,没标题的只给 `text`,例子里用 `or` 依次兜底;媒体在 `medias` 里,同一个媒体的多档清晰度在 `variants` 里——挑 `is_default` 为 `true` 的那一档就是推荐清晰度。拿到的媒体直链是短效的,取到后尽快下载;如果 media 上带了 `headers`,下载请求要把这些头原样带上,否则会被平台拒绝。
```python
import requests
api_url = "https://api.meowload.net/openapi/v1/extract/post"
api_key = "<你的 API Key>"
payload = {"url": "https://www.youtube.com/watch?v=dQw4w9WgXcQ"}
headers = {"Authorization": f"Bearer {api_key}", "Accept-Language": "zh"}
response = requests.post(api_url, json=payload, headers=headers)
if response.status_code == 200:
data = response.json()
# title 与 text 都是可选的:有标题的平台取 title,其余取 text
caption = data.get("title") or data.get("text") or "无"
print(f"✅ 提取成功,平台: {data.get('site')},文案: {caption}")
for media in data["medias"]:
print(f"- {media['media_type']}: {media['resource_url']}")
# 多清晰度 / 多音轨在 variants 里;video_url 与 audio_url 同时存在表示音视频分离
for variant in media.get("variants", []):
split = "(需合并)" if variant.get("video_url") and variant.get("audio_url") else ""
print(f" {variant.get('quality_label', '默认')}{split}")
else:
error = response.json()
print(f"❌ 请求失败 ({response.status_code}): {error['message']}")
if error.get("retryable"):
print(f" 错误码 {error['code']} 是临时失败,可稍后重试")
```
## 🎯 使用 aiohttp 异步调用
要跑几十上百条链接时逐条同步等待太慢,用 `aiohttp` 把请求并发出去更合适。这里最容易出事的是并发数:`asyncio.gather` 会把所有任务一起放出去,链接一多就撞上每个 Key 每分钟 1200 次的限流拿到 429,实际用时套一个 `asyncio.Semaphore` 控制同时在飞的请求数,并对 429 退避重试。
另一处是异常:`gather` 默认会让第一个抛出的异常终止整批,所以例子把失败也当成一条结果返回,一条链接失败不影响其余的。示例为了简短在每次调用里各建了一个 `ClientSession`,批量场景把它提到外层共用,能省掉重复的连接建立开销。
```python
import aiohttp
import asyncio
async def extract_async(url, api_key):
api_url = "https://api.meowload.net/openapi/v1/extract/post"
async with aiohttp.ClientSession() as session:
async with session.post(
api_url,
json={"url": url},
headers={"Authorization": f"Bearer {api_key}"}
) as response:
data = await response.json()
if response.status != 200:
# 400 带 code 与 retryable,retryable 为 True 时可稍后重试
return {"url": url, "error": data}
return {"url": url, "result": data}
# 并发提取多个 URL
async def batch_extract(urls, api_key):
tasks = [extract_async(url, api_key) for url in urls]
return await asyncio.gather(*tasks)
# 运行
urls = [
"https://www.youtube.com/watch?v=video1",
"https://www.youtube.com/watch?v=video2",
]
results = asyncio.run(batch_extract(urls, "<你的 API Key>"))
for item in results:
if "error" in item:
error = item["error"]
print(f"❌ {item['url']}: {error['message']} ({error.get('code')}, retryable={error.get('retryable')})")
else:
print(f"✅ {item['url']}: {len(item['result']['medias'])} 个媒体")
```
把示例跑通之后,可以顺着这几篇继续:
- [快速开始](https://docs.henghengmao.com/developer/quickstart):拿 Key、发第一个请求、看懂响应字段
- [单帖提取接口](https://docs.henghengmao.com/developer/media-downloader-api):这两段示例调的就是它,支持的平台与参数都在这里
- [POST /extract/post 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/post):完整的请求体与响应定义,页面上可以直接调试
- [错误码](https://docs.henghengmao.com/developer/errors):18 个 `code` 的含义,以及 `retryable` 该怎么读
- [批量提取接口](https://docs.henghengmao.com/developer/playlist-downloader-api):把上面的并发写法换成按 `has_more` 与 `next_cursor` 翻页
---
# JavaScript 代码示例
> JavaScript 调用哼哼猫提取接口的完整示例:Fetch API、Axios 与 async/await 三种写法,都带上了非 200 响应的错误码与重试处理。
来源: https://docs.henghengmao.com/developer/code-example/javascript
Node 18 起内置了 `fetch`,调这套接口不装任何依赖就能跑;项目里已经在用 axios 的,直接用 axios 也一样。
本页给三段可以直接抄的代码:Promise 链写法的 `fetch`、axios,以及最接近生产用法的 `async/await` 封装。API Key 只能放在服务端——写进前端页面等于把它公开出去,浏览器里需要提取能力时应该由自己的后端转发一次。
## 🚀 使用 Fetch API
最短的能跑通的写法,Node 与浏览器里的 API 一致。`fetch` 有一处和别的 HTTP 库都不同:400、401、429 都不会让它 reject,只有 DNS 解析、连接失败这类网络层错误才会,所以必须先判断 `response.ok`,否则会拿着错误体去读 `data.medias`。错误体同样是 JSON,要再 `.json()` 一次才能读到 `code` 与 `retryable`。
响应里 `title` 与 `text` 都是可选字段,两个可能同时有、也可能只有 `text`,展示文案写 `data.title || data.text` 就够;媒体清单在 `medias`,每个媒体的可选清晰度在 `variants` 里,`is_default` 为 `true` 的那档是推荐值。`video_url` 与 `audio_url` 同时出现说明是音视频分离的流,两条都要下载再合并。
```javascript
const apiUrl = "https://api.meowload.net/openapi/v1/extract/post";
const apiKey = "<你的 API Key>";
fetch(apiUrl, {
method: "POST",
headers: {
"Content-Type": "application/json",
"Authorization": `Bearer ${apiKey}`,
"Accept-Language": "zh"
},
body: JSON.stringify({
url: "https://www.youtube.com/watch?v=dQw4w9WgXcQ"
})
})
.then(response => {
if (!response.ok) {
// 400 的错误体带 code 与 retryable
return response.json().then(error => {
throw Object.assign(new Error(`${response.status}: ${error.message}`), {
code: error.code,
retryable: error.retryable === true
});
});
}
return response.json();
})
.then(data => {
// title 与 text 都是可选的:有标题的平台取 title,其余取 text
console.log(`✅ 提取成功,平台: ${data.site},文案: ${data.title || data.text || "无"}`);
data.medias.forEach(media => {
console.log(`- ${media.media_type}: ${media.resource_url}`);
// 多清晰度 / 多音轨在 variants 里;video_url 与 audio_url 同时存在表示音视频分离
for (const variant of media.variants ?? []) {
const split = variant.video_url && variant.audio_url ? "(需合并)" : "";
console.log(` ${variant.quality_label ?? "默认"}${split}`);
}
});
})
.catch(error => {
console.error(`❌ 请求失败: ${error.message}`);
if (error.retryable) console.error(` 错误码 ${error.code} 是临时失败,可稍后重试`);
});
```
## 📦 使用 Axios(Node.js)
项目里已有 axios,或者想用拦截器统一加请求头、统一记日志时用这段。和 `fetch` 相反,axios 会把非 2xx 直接扔进 `catch`,但错误详情在 `error.response.data` 里而不是 `error.message`——只打印 `error.message` 会得到一句没有信息量的「Request failed with status code 400」。
`error.response` 为空表示请求根本没拿到响应(超时、连接被拒)。axios 默认不设超时,生产代码建议显式配 `timeout`,并对 429 和 `retryable` 为 `true` 的错误做退避重试。
```bash
npm install axios
```
```javascript
const axios = require('axios');
const apiUrl = "https://api.meowload.net/openapi/v1/extract/post";
const apiKey = "<你的 API Key>";
axios.post(apiUrl, {
url: "https://www.youtube.com/watch?v=dQw4w9WgXcQ"
}, {
headers: {
"Authorization": `Bearer ${apiKey}`,
"Accept-Language": "zh"
}
})
.then(response => {
const data = response.data;
console.log(`✅ 提取成功,平台: ${data.site},文案: ${data.title || data.text || "无"},媒体数量: ${data.medias.length}`);
})
.catch(error => {
if (error.response) {
const { status, data } = error.response;
console.error(`❌ 请求失败 (${status}): ${data.message}`);
// 400 带 code 与 retryable;429 需退避重试
if (data.retryable) console.error(` 错误码 ${data.code} 是临时失败,可稍后重试`);
} else {
console.error(`❌ 网络错误: ${error.message}`);
}
});
```
## 🎯 使用 async/await
真正会放进项目里的形态:把提取包成一个函数,成功返回数据,失败抛一个带 `status`、`code`、`retryable` 的错误,调用方在一处决定要不要重试。这里先 `await response.json()` 再判断 `response.ok`,是因为成功体和错误体都是 JSON,一次解析两边都能用。
要注意代理或中间层返回的错误页未必是 JSON,`json()` 会抛解析错误,生产代码可以先看 `content-type` 或包一层 `try`。拿到结果后媒体直链要尽快下载,它是短效的,别存进数据库当长期地址用。
```javascript
async function extractPost(url, apiKey) {
const response = await fetch("https://api.meowload.net/openapi/v1/extract/post", {
method: "POST",
headers: {
"Content-Type": "application/json",
"Authorization": `Bearer ${apiKey}`
},
body: JSON.stringify({ url })
});
const data = await response.json();
if (!response.ok) {
// 把 code 与 retryable 带出去,调用方据此决定要不要重试
throw Object.assign(new Error(data.message), {
status: response.status,
code: data.code,
retryable: data.retryable === true
});
}
return data;
}
// 使用
try {
const result = await extractPost("https://www.youtube.com/watch?v=dQw4w9WgXcQ", "<你的 API Key>");
console.log(`✅ ${result.title || result.text || "无"},媒体数量: ${result.medias.length}`);
} catch (error) {
console.error(`提取失败: ${error.message}${error.retryable ? "(可稍后重试)" : ""}`);
}
```
接着可以看这几页:
- [快速开始](https://docs.henghengmao.com/developer/quickstart):从拿 Key 到第一个成功响应的完整路径
- [错误码](https://docs.henghengmao.com/developer/errors):`code` 与 `retryable` 的完整对照表,写重试逻辑前先看它
- [POST /extract/post 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/post):请求体、响应字段与在线调试
- [单帖提取接口](https://docs.henghengmao.com/developer/media-downloader-api):上面三段示例对应的接口说明
- [MCP 接入](https://docs.henghengmao.com/developer/mcp):不想写代码时,在 Claude Code、Cursor 里直接调这套能力
---
# PHP 代码示例
> PHP 调用哼哼猫提取接口的完整示例:file_get_contents 与 cURL 两种写法,含状态码判断与错误体解析,可直接搬进生产代码。
来源: https://docs.henghengmao.com/developer/code-example/php
PHP 调这套接口不需要额外依赖:`allow_url_fopen` 开着时 `file_get_contents` 就能发 POST,装了 cURL 扩展(多数环境默认带)则用 cURL 更可控。
本页给两段代码:一段是能贴进任何脚本的最短写法,一段是带异常类的封装。鉴权都是 `Authorization: Bearer <你的 API Key>` 请求头,只有成功的请求才扣 API 积分。
## 🚀 使用 file_get_contents
适合小脚本,或者主机不让装扩展的环境。这种写法有两个坑几乎人人踩到:不加 `ignore_errors`,非 200 时 `file_get_contents` 会直接返回 `false` 并抛 warning,错误体根本读不到;状态码也没有返回值可取,只能从 `$http_response_header` 里解析——这个变量是函数执行后被注入到当前作用域的,只在发起调用的那个函数里可见。
它默认用 `php.ini` 的 `default_socket_timeout`(通常 60 秒),要自己控制超时得在 `http` 选项里补一个 `timeout`。响应里的 `title` 与 `text` 都是可选字段,例子用 `??` 依次兜底;媒体的多档清晰度在 `variants` 里,取 `is_default` 为真的那一档即可。
```php
";
$params = array("url" => "https://www.youtube.com/watch?v=dQw4w9WgXcQ");
$options = array(
"http" => array(
"header" =>
"Content-Type: application/json\r\n" .
"Authorization: Bearer " . $apiKey . "\r\n" .
"Accept-Language: zh",
"method" => "POST",
"content" => json_encode($params),
"ignore_errors" => true, // 非 200 时也读取响应体,否则拿不到错误信息
),
);
$context = stream_context_create($options);
$response = file_get_contents($apiUrl, false, $context);
// 解析 HTTP 响应状态码
$statusLine = $http_response_header[0];
preg_match('{HTTP\/\S*\s(\d{3})}', $statusLine, $match);
$statusCode = $match[1];
$data = json_decode($response, true);
if ($statusCode == 200) {
// title 与 text 都是可选的:有标题的平台取 title,其余取 text
$caption = $data['title'] ?? $data['text'] ?? '无';
echo "✅ 提取成功,平台: " . ($data['site'] ?? '未知') . ",文案: " . $caption . "\n";
foreach ($data['medias'] as $media) {
echo "- " . $media['media_type'] . ": " . $media['resource_url'] . "\n";
// 多清晰度 / 多音轨在 variants 里;video_url 与 audio_url 同时存在表示音视频分离
foreach ($media['variants'] ?? array() as $variant) {
$split = (!empty($variant['video_url']) && !empty($variant['audio_url'])) ? "(需合并)" : "";
echo " " . ($variant['quality_label'] ?? '默认') . $split . "\n";
}
}
} else {
echo "❌ 请求失败 (" . $statusCode . "): " . $data['message'] . "\n";
if (!empty($data['retryable'])) {
echo " 错误码 " . $data['code'] . " 是临时失败,可稍后重试\n";
}
}
?>
```
## 📦 使用 cURL
生产代码建议用这段:状态码、错误码、是否可重试一起塞进异常,上层一处 `catch` 就能判断。`CURLOPT_RETURNTRANSFER` 不能漏——不设它 `curl_exec` 会把响应直接打到输出、只返回 `true`,`json_decode` 拿到的是空。
还要分清两种失败:`curl_exec` 返回 `false` 是网络层出错,此时才该看 `curl_error`;而 HTTP 400 是接口正常返回的业务失败,响应体里带 `code` 与 `retryable`,`retryable` 为真才值得退避重试。再补一个 `CURLOPT_TIMEOUT`,默认不限时会让脚本卡死。下载媒体直链时,若那条 media 带了 `headers`,要用 `CURLOPT_HTTPHEADER` 原样带上。
```php
code = $code;
$this->retryable = $retryable;
}
}
function extractPost($url, $apiKey) {
$apiUrl = "https://api.meowload.net/openapi/v1/extract/post";
$ch = curl_init($apiUrl);
$payload = json_encode(array("url" => $url));
curl_setopt($ch, CURLOPT_POSTFIELDS, $payload);
curl_setopt($ch, CURLOPT_HTTPHEADER, array(
'Content-Type: application/json',
'Authorization: Bearer ' . $apiKey,
'Accept-Language: zh'
));
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
$response = curl_exec($ch);
$statusCode = curl_getinfo($ch, CURLINFO_HTTP_CODE);
curl_close($ch);
$data = json_decode($response, true);
if ($statusCode == 200) {
return $data;
}
// 400 带 code 与 retryable;401/402/422/429 只看状态码
throw new ExtractException(
$data['message'],
$statusCode,
$data['code'] ?? null,
!empty($data['retryable'])
);
}
// 使用
try {
$result = extractPost("https://www.youtube.com/watch?v=dQw4w9WgXcQ", "<你的 API Key>");
$caption = $result['title'] ?? $result['text'] ?? '无';
echo "✅ 提取成功,文案: " . $caption . ",媒体数量: " . count($result['medias']) . "\n";
} catch (ExtractException $e) {
echo "❌ 错误 (" . $e->getCode() . "): " . $e->getMessage() . "\n";
if ($e->retryable) {
echo " 错误码 " . $e->code . " 是临时失败,可稍后重试\n";
}
}
?>
```
写完这段可以继续看:
- [快速开始](https://docs.henghengmao.com/developer/quickstart):注册、取 Key 到第一个请求的完整路径
- [POST /extract/post 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/post):字段定义,可以在页面上直接试
- [单帖提取接口](https://docs.henghengmao.com/developer/media-downloader-api):示例调用的就是它,支持平台与限制都在这里
- [错误码](https://docs.henghengmao.com/developer/errors):把 `code` 映射成自己系统里的提示文案时对着这张表
- [从老版本迁移](https://docs.henghengmao.com/developer/migration):还在用 `userId` 加 `secretKey` 的老接口,这里是字段对照
---
# Golang 代码示例
> Golang 调用哼哼猫提取接口的完整示例:net/http 标准库直接请求,以及一个可复用的客户端封装,含结构体解析与错误处理。
来源: https://docs.henghengmao.com/developer/code-example/golang
Go 用标准库的 `net/http` 加 `encoding/json` 就能调完这套接口,不需要任何第三方 SDK。
本页给两段:先是一个能直接 `go run` 的最小例子,再是一份把响应结构体、错误类型和客户端都定义好的封装,后者可以整段复制进项目。
## 🚀 快速开始
用来验证 Key 与网络是否通,跑通了再往下抄封装那段。例子为了短把几处 `err` 用 `_` 忽略了,搬进生产要逐个处理。真正要改的是 `http.Client{}`:零值没有超时,目标平台卡住时这个请求会一直挂着,务必设 `Timeout`(一次提取偶尔要十几秒,别设太短)。
`defer resp.Body.Close()` 也不能省,而且要把 body 读完,否则这条连接进不了复用池。非 200 的响应体统一是 `{message, code?, retryable?}`(只有 `message` 一定有,`code` 与 `retryable` 是提取失败的 400 才带的,401、402、422、500 只有 `message`),这段只原样打印,字段怎么落进结构体见下一节。
```go
package main
import (
"bytes"
"encoding/json"
"fmt"
"io"
"net/http"
)
func main() {
apiURL := "https://api.meowload.net/openapi/v1/extract/post"
apiKey := "<你的 API Key>"
// 构造请求
payload := map[string]string{
"url": "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
}
jsonData, _ := json.Marshal(payload)
req, _ := http.NewRequest("POST", apiURL, bytes.NewBuffer(jsonData))
req.Header.Set("Content-Type", "application/json")
req.Header.Set("Authorization", "Bearer "+apiKey)
req.Header.Set("Accept-Language", "zh")
// 发送请求
client := &http.Client{}
resp, err := client.Do(req)
if err != nil {
fmt.Printf("❌ 网络错误: %v\n", err)
return
}
defer resp.Body.Close()
// 处理响应
body, _ := io.ReadAll(resp.Body)
if resp.StatusCode == 200 {
fmt.Println("✅ 请求成功")
fmt.Println(string(body))
} else {
// 非 200 的响应体统一是 { message, code?, retryable? }
fmt.Printf("❌ 请求失败 (%d)\n", resp.StatusCode)
fmt.Println(string(body))
}
}
```
## 📦 完整封装示例
长期使用的形态:`ExtractResponse` 描述成功响应,`APIError` 把 HTTP 状态码和错误体一起带出去,调用方用 `errors.As` 取出来看 `Retryable` 决定是否退避重试。可选字段都带 `omitempty`,用之前要判空——`Title` 与 `Text` 都可能是空串,有标题的平台两个都可能有、没标题的只给 `Text`,展示文案走下面的 `Caption()` 先取 `Title` 再回退 `Text`;`Author` 是指针,先判 `nil` 再取。
媒体在 `Medias` 里,同一媒体的多档清晰度在 `Variants` 里,`IsDefault` 为 `true` 的那档是推荐清晰度;`VideoURL` 与 `AudioURL` 同时非空说明是音视频分离的流,要各自下完再合并。`Media.Headers` 非空时,下载请求必须原样带上这些头。另外例子里解析错误体的 `json.Unmarshal` 忽略了返回值,万一响应体不是 JSON(例如中间代理返回的 HTML 错误页)会得到一个空 message,生产代码至少要把原始 body 留在日志里。与上一节的裸请求不同,`NewClient` 这里给 `http.Client` 设了 60 秒 `Timeout`——这个客户端活得比单次请求久得多,不设的话一次卡住的提取会永远占着一个 goroutine。
```go
package main
import (
"bytes"
"encoding/json"
"errors"
"fmt"
"io"
"net/http"
"time"
)
type MeowLoadClient struct {
APIKey string
BaseURL string
Client *http.Client
}
type ExtractRequest struct {
URL string `json:"url"`
}
// Variant 是同一媒体的一个清晰度档或音轨。
// VideoURL 与 AudioURL 同时非空表示音视频分离,需要各自下载后合并。
type Variant struct {
Quality int `json:"quality,omitempty"` // 高度像素,9999 表示原画
QualityLabel string `json:"quality_label,omitempty"`
VideoURL string `json:"video_url,omitempty"`
VideoExt string `json:"video_ext,omitempty"`
VideoFilesize int64 `json:"video_filesize,omitempty"`
AudioURL string `json:"audio_url,omitempty"`
AudioExt string `json:"audio_ext,omitempty"`
AudioFilesize int64 `json:"audio_filesize,omitempty"`
IsDefault bool `json:"is_default,omitempty"`
LanguageTag string `json:"language_tag,omitempty"`
LanguageName string `json:"language_name,omitempty"`
}
type Media struct {
MediaType string `json:"media_type"`
ResourceURL string `json:"resource_url"`
PreviewURL string `json:"preview_url,omitempty"`
Headers map[string]string `json:"headers,omitempty"`
Duration float64 `json:"duration,omitempty"`
Variants []Variant `json:"variants,omitempty"`
}
type Profile struct {
Username string `json:"username"`
DisplayName string `json:"display_name,omitempty"`
AvatarURL string `json:"avatar_url,omitempty"`
}
type ExtractResponse struct {
Site string `json:"site,omitempty"`
Title string `json:"title,omitempty"` // 有标题的平台才有
Text string `json:"text,omitempty"` // 正文 / 文案
Medias []Media `json:"medias"`
ID string `json:"id,omitempty"`
CreatedAt string `json:"created_at,omitempty"`
Author *Profile `json:"author,omitempty"`
PostURL string `json:"post_url,omitempty"`
}
// Caption 返回展示用文案:有标题取标题,否则取正文
func (r *ExtractResponse) Caption() string {
if r.Title != "" {
return r.Title
}
return r.Text
}
// ErrorResponse 是所有非 200 响应的统一形状。Code 与 Retryable 在 400 时一定有
type ErrorResponse struct {
Message string `json:"message"`
Code string `json:"code,omitempty"`
Retryable bool `json:"retryable,omitempty"`
}
// APIError 把 HTTP 状态码与错误体一起带出去,调用方据此决定要不要重试
type APIError struct {
StatusCode int
ErrorResponse
}
func (e *APIError) Error() string {
if e.Code != "" {
return fmt.Sprintf("请求失败 (%d): %s [code=%s retryable=%t]", e.StatusCode, e.Message, e.Code, e.Retryable)
}
return fmt.Sprintf("请求失败 (%d): %s", e.StatusCode, e.Message)
}
// NewClient 创建新的 API 客户端
func NewClient(apiKey string) *MeowLoadClient {
return &MeowLoadClient{
APIKey: apiKey,
BaseURL: "https://api.meowload.net/openapi/v1",
// 客户端活得比单次请求久得多,零值 http.Client 没有超时,卡住的提取会一直占着 goroutine
Client: &http.Client{Timeout: 60 * time.Second},
}
}
// ExtractPost 提取单个帖子
func (c *MeowLoadClient) ExtractPost(url string) (*ExtractResponse, error) {
endpoint := c.BaseURL + "/extract/post"
// 构造请求
reqBody := ExtractRequest{URL: url}
jsonData, err := json.Marshal(reqBody)
if err != nil {
return nil, fmt.Errorf("JSON 序列化失败: %w", err)
}
// 创建 HTTP 请求
req, err := http.NewRequest("POST", endpoint, bytes.NewBuffer(jsonData))
if err != nil {
return nil, fmt.Errorf("创建请求失败: %w", err)
}
// 设置请求头
req.Header.Set("Content-Type", "application/json")
req.Header.Set("Authorization", "Bearer "+c.APIKey)
req.Header.Set("Accept-Language", "zh")
// 发送请求
resp, err := c.Client.Do(req)
if err != nil {
return nil, fmt.Errorf("发送请求失败: %w", err)
}
defer resp.Body.Close()
// 读取响应
body, err := io.ReadAll(resp.Body)
if err != nil {
return nil, fmt.Errorf("读取响应失败: %w", err)
}
// 处理错误响应
if resp.StatusCode != 200 {
apiErr := &APIError{StatusCode: resp.StatusCode}
json.Unmarshal(body, &apiErr.ErrorResponse)
return nil, apiErr
}
// 解析成功响应
var result ExtractResponse
if err := json.Unmarshal(body, &result); err != nil {
return nil, fmt.Errorf("解析响应失败: %w", err)
}
return &result, nil
}
func main() {
// 创建客户端
client := NewClient("<你的 API Key>")
// 提取帖子
result, err := client.ExtractPost("https://www.bilibili.com/video/BV1sG4y1p7TA/")
if err != nil {
fmt.Printf("❌ 错误: %v\n", err)
var apiErr *APIError
if errors.As(err, &apiErr) && apiErr.Retryable {
fmt.Println(" 临时失败,可稍后重试")
}
return
}
fmt.Println("✅ 提取成功")
fmt.Printf("平台: %s\n", result.Site)
fmt.Printf("文案: %s\n", result.Caption())
if result.Author != nil {
fmt.Printf("作者: %s\n", result.Author.Username)
}
fmt.Printf("媒体数量: %d\n", len(result.Medias))
for idx, media := range result.Medias {
fmt.Printf("\n媒体 %d:\n", idx+1)
fmt.Printf(" 类型: %s\n", media.MediaType)
fmt.Printf(" 地址: %s\n", media.ResourceURL)
for _, v := range media.Variants {
split := ""
if v.VideoURL != "" && v.AudioURL != "" {
split = "(需合并)"
}
fmt.Printf(" - %s%s\n", v.QualityLabel, split)
}
}
}
```
接下来这几页会用得上:
- [快速开始](https://docs.henghengmao.com/developer/quickstart):接口全貌与第一个 curl 请求
- [POST /extract/post 参考](https://docs.henghengmao.com/developer/api-reference#POST/extract/post):结构体 tag 的权威来源,改字段前先对一遍
- [单帖提取接口](https://docs.henghengmao.com/developer/media-downloader-api):本页示例对应的接口
- [字幕提取接口](https://docs.henghengmao.com/developer/video-subtitle-downloader-api):鉴权与 `APIError` 这层可以照搬,响应是 `subtitles[]` 不是 `medias`,结构体要另写
- [错误码](https://docs.henghengmao.com/developer/errors):`APIError` 里那个 `Code` 的全部取值
---
# 从老版本迁移
> 老版本(无版本号)接口升级到 v1 的迁移指南:接口地址、鉴权改为 Bearer、帖子文案与媒体字段的改名对照表、错误响应变化与迁移清单。
来源: https://docs.henghengmao.com/developer/migration
v1 与老版本接口(无版本号的 `/openapi/…`)用同一个 API Key、同一套计费,请求参数也没有变。变的是**响应**:老版本返回的是多年前定下的老形状,v1 直接返回提取引擎的当前形状。本页逐条列出差异,改完这些你的调用方就能切到 v1。
老版本接口会继续保留、不设下线日期,但不再增加新字段。
## 变了什么
| 项目 | 老版本接口 | v1 |
| ---------------- | ----------------------------------------- | ------------------------------------------------------ |
| 地址前缀 | `/openapi` | `/openapi/v1` |
| 鉴权 | `X-API-Key` 请求头 | `Authorization: Bearer <你的 API Key>` 请求头 |
| 帖子文案 | 单个 `text` | `title` + `text` |
| 多清晰度列表 | `formats` | `variants`,内部字段同步改名 |
| 音视频分离标志 | `separate` | 已移除,按 `video_url` 与 `audio_url` 是否同时存在判断 |
| 作者信息 | `user` | 帖子里是 `author`,主页批量里是 `profile` |
| 平台 id | 无 | 新增 `site` |
| 错误响应 | `{ message, code }`,`code` 为 PascalCase | `{ message, code, retryable }`,`code` 为 snake_case |
| 查询额度 | `GET /available-credits` | `GET /credits`,响应不变 |
| 限流 | 每秒 20 次 | 每个 Key 每分钟 1200 次(同为每秒 20 次),超出返回 `429` |
## 接口地址
| 老版本接口 | v1 |
| --------------------------------------------------------- | ------------------------------------------------------------ |
| `POST https://api.meowload.net/openapi/extract/post` | `POST https://api.meowload.net/openapi/v1/extract/post` |
| `POST https://api.meowload.net/openapi/extract/playlist` | `POST https://api.meowload.net/openapi/v1/extract/playlist` |
| `POST https://api.meowload.net/openapi/extract/subtitles` | `POST https://api.meowload.net/openapi/v1/extract/subtitles` |
| `GET https://api.meowload.net/openapi/available-credits` | `GET https://api.meowload.net/openapi/v1/credits` |
请求体与老版本完全相同:body 里传 `url`(主页批量另有可选的 `cursor`),可选的 `Accept-Language` 请求头也一样。鉴权头有变化:老版本用 `X-API-Key`,v1 用 `Authorization: Bearer <你的 API Key>`,Key 本身不变。
## 帖子的 text 拆成 title 和 text
老版本只有一个 `text`,语义是混的:有标题的平台放标题,没标题的平台放正文。v1 拆成两个字段:
| 字段 | 含义 | 何时存在 |
| ------- | ------------------ | ------------------------------------------------ |
| `title` | 标题 | 有标题的平台(YouTube、B 站、小红书、Reddit 等) |
| `text` | 正文 / 文案 / 简介 | 大多数平台 |
两个都是可选的。想得到与老版本大致相同的展示文案,用 `title || text`。
这条适用于 `/extract/post` 的响应,以及 `/extract/playlist` 响应里 `posts[]` 的每一条。
## 媒体字段改名
`medias[]` 里的多清晰度列表从 `formats` 改名为 `variants`,因为它对音频媒体表示的是**音轨**而不是格式。数组内部的字段同步改名:
| 老版本接口 | v1 | 说明 |
| -------------- | ---------------- | ---------------------------------------------- |
| `formats` | `variants` | 数组本身 |
| `quality_note` | `quality_label` | 展示用清晰度标注,如 `1080p`、`4K`、`Original` |
| `video_size` | `video_filesize` | 视频文件大小(字节) |
| `audio_size` | `audio_filesize` | 音频文件大小(字节) |
| `default` | `is_default` | 是否为推荐档 / 默认音轨 |
| `separate` | 已移除 | 见下一节 |
`quality`、`fps`、`video_url`、`video_ext`、`video_codec`、`audio_url`、`audio_ext`、`audio_codec`、`language_tag`、`language_name` 名字不变。`quality` 为 `9999` 表示原画(真实分辨率不可知的源文件),对应的 `quality_label` 固定为 `Original`。
## separate 已移除
老版本用 `separate: 1 / 0` 标记音视频是否分离。v1 不再下发这个字段,判断规则是:
**一个变体同时有 `video_url` 和 `audio_url`,就是分离流,需要各自下载后合并;只有其中一个就是单文件,直接下载。**
```python
def is_split(variant):
return bool(variant.get("video_url")) and bool(variant.get("audio_url"))
```
## 新增 site
v1 的三个提取接口响应顶层都多了一个可选的 `site`:这条链接归属的平台 id,如 `youtube`、`tiktok`、`instagram`。你可以据此分流处理逻辑,不必自己维护域名表。无法归类时整个键省略。
## 错误响应
老版本的错误体文档只写了 `message`,实际还带一个 PascalCase 的 `code`。v1 的错误体是:
```json
{
"message": "该内容已被删除或不存在",
"code": "content_deleted",
"retryable": false
}
```
三处变化:`code` 改为 snake_case;新增 `retryable`,告诉你同一链接稍后重试是否可能成功;`400` 保证带 `code`。18 个错误码的对照:
| 老版本接口(PascalCase) | v1(snake_case) |
| ------------------------ | --------------------------- |
| `Unknown` | `unknown` |
| `Timeout` | `timeout` |
| `InvalidURL` | `invalid_url` |
| `ExtractFailed` | `extract_failed` |
| `UnsupportedURL` | `unsupported_url` |
| `UnsupportedSite` | `unsupported_site` |
| `PrivateContent` | `private_content` |
| `LiveStreamNotSupported` | `live_stream_not_supported` |
| `PlaylistNotSupported` | `playlist_not_supported` |
| `UserNotFound` | `user_not_found` |
| `NoStory` | `no_story` |
| `ContentDeleted` | `content_deleted` |
| `InvalidPlaylistURL` | `invalid_playlist_url` |
| `MembersOnlyContent` | `members_only_content` |
| `NotPremiered` | `not_premiered` |
| `AgeRestricted` | `age_restricted` |
| `RegionRestricted` | `region_restricted` |
| `Retryable` | `retryable` |
另有一处状态码统一:老版本里链接格式不合法时,单帖接口返回 `422`、主页批量与字幕接口返回 `400`;v1 一律 `400` + `code: "invalid_url"`。`422` 在 v1 只用于请求体本身不合法(如缺 `url`)。每个错误码的含义与处理建议见 [错误码](https://docs.henghengmao.com/developer/errors)。
## 查询额度接口改名
`GET /openapi/available-credits` 改为 `GET /openapi/v1/credits`,响应体完全不变:
```json
{ "availableCredits": 282539 }
```
## 迁移清单
1. 地址前缀改为 `/openapi/v1`,`available-credits` 改为 `credits`
2. 鉴权头换成 `Authorization: Bearer <你的 API Key>`
3. 帖子文案改读 `title` / `text`
4. `formats` 改 `variants`,内部 `quality_note` / `video_size` / `audio_size` / `default` 换成新名
5. 删掉对 `separate` 的读取,改为判断 `video_url` 与 `audio_url` 是否同时存在
6. 错误处理改按 snake_case 的 `code` 分支,`retryable` 为 `true` 时允许延迟重试
7. 为 `429` 加退避逻辑
8. 用 [API 参考](https://docs.henghengmao.com/developer/api-reference) 的在线调试对照一次真实响应
改好后的各语言示例见 [Python](https://docs.henghengmao.com/developer/code-example/python)、[JavaScript](https://docs.henghengmao.com/developer/code-example/javascript)、[PHP](https://docs.henghengmao.com/developer/code-example/php)、[Golang](https://docs.henghengmao.com/developer/code-example/golang)。
## 查看老版本文档
老版本接口的文档在 GitHub 仓库 [MeowLoad/Media-Downloader-API](https://github.com/MeowLoad/Media-Downloader-API):
- [单个帖子(视频|图集|音乐)提取接口](https://github.com/MeowLoad/Media-Downloader-API/blob/main/%F0%9F%93%84%20%E5%8D%95%E4%B8%AA%E5%B8%96%E5%AD%90%28%E8%A7%86%E9%A2%91%7C%E5%9B%BE%E9%9B%86%7C%E9%9F%B3%E4%B9%90%29%E6%8F%90%E5%8F%96%E6%8E%A5%E5%8F%A3.md)
- [主页(播放列表|频道|话题)批量提取接口](https://github.com/MeowLoad/Media-Downloader-API/blob/main/%F0%9F%93%84%20%E4%B8%BB%E9%A1%B5%28%E6%92%AD%E6%94%BE%E5%88%97%E8%A1%A8%7C%E9%A2%91%E9%81%93%7C%E8%AF%9D%E9%A2%98%29%E6%89%B9%E9%87%8F%E6%8F%90%E5%8F%96%E6%8E%A5%E5%8F%A3.md)
- [字幕提取接口](https://github.com/MeowLoad/Media-Downloader-API/blob/main/%F0%9F%93%84%20%E5%AD%97%E5%B9%95%E6%8F%90%E5%8F%96%E6%8E%A5%E5%8F%A3.md)
- [查询剩余 API 积分接口](https://github.com/MeowLoad/Media-Downloader-API/blob/main/%F0%9F%93%84%20%E6%9F%A5%E8%AF%A2%E5%89%A9%E4%BD%99%E5%8F%AF%E7%94%A8%E6%AC%A1%E6%95%B0%E6%8E%A5%E5%8F%A3.md)